Runlix
Il motore, la chat, il server. Un'app sola.
Runlix esegue modelli AI sul tuo Mac: un motore Rust proprio su MLX, una chat che sa usare strumenti, e un server a cui si collegano gli altri programmi. macOS 14 e successivi, Apple Silicon.
Aggiornato 2026-09-12Misurato 2026-09-07
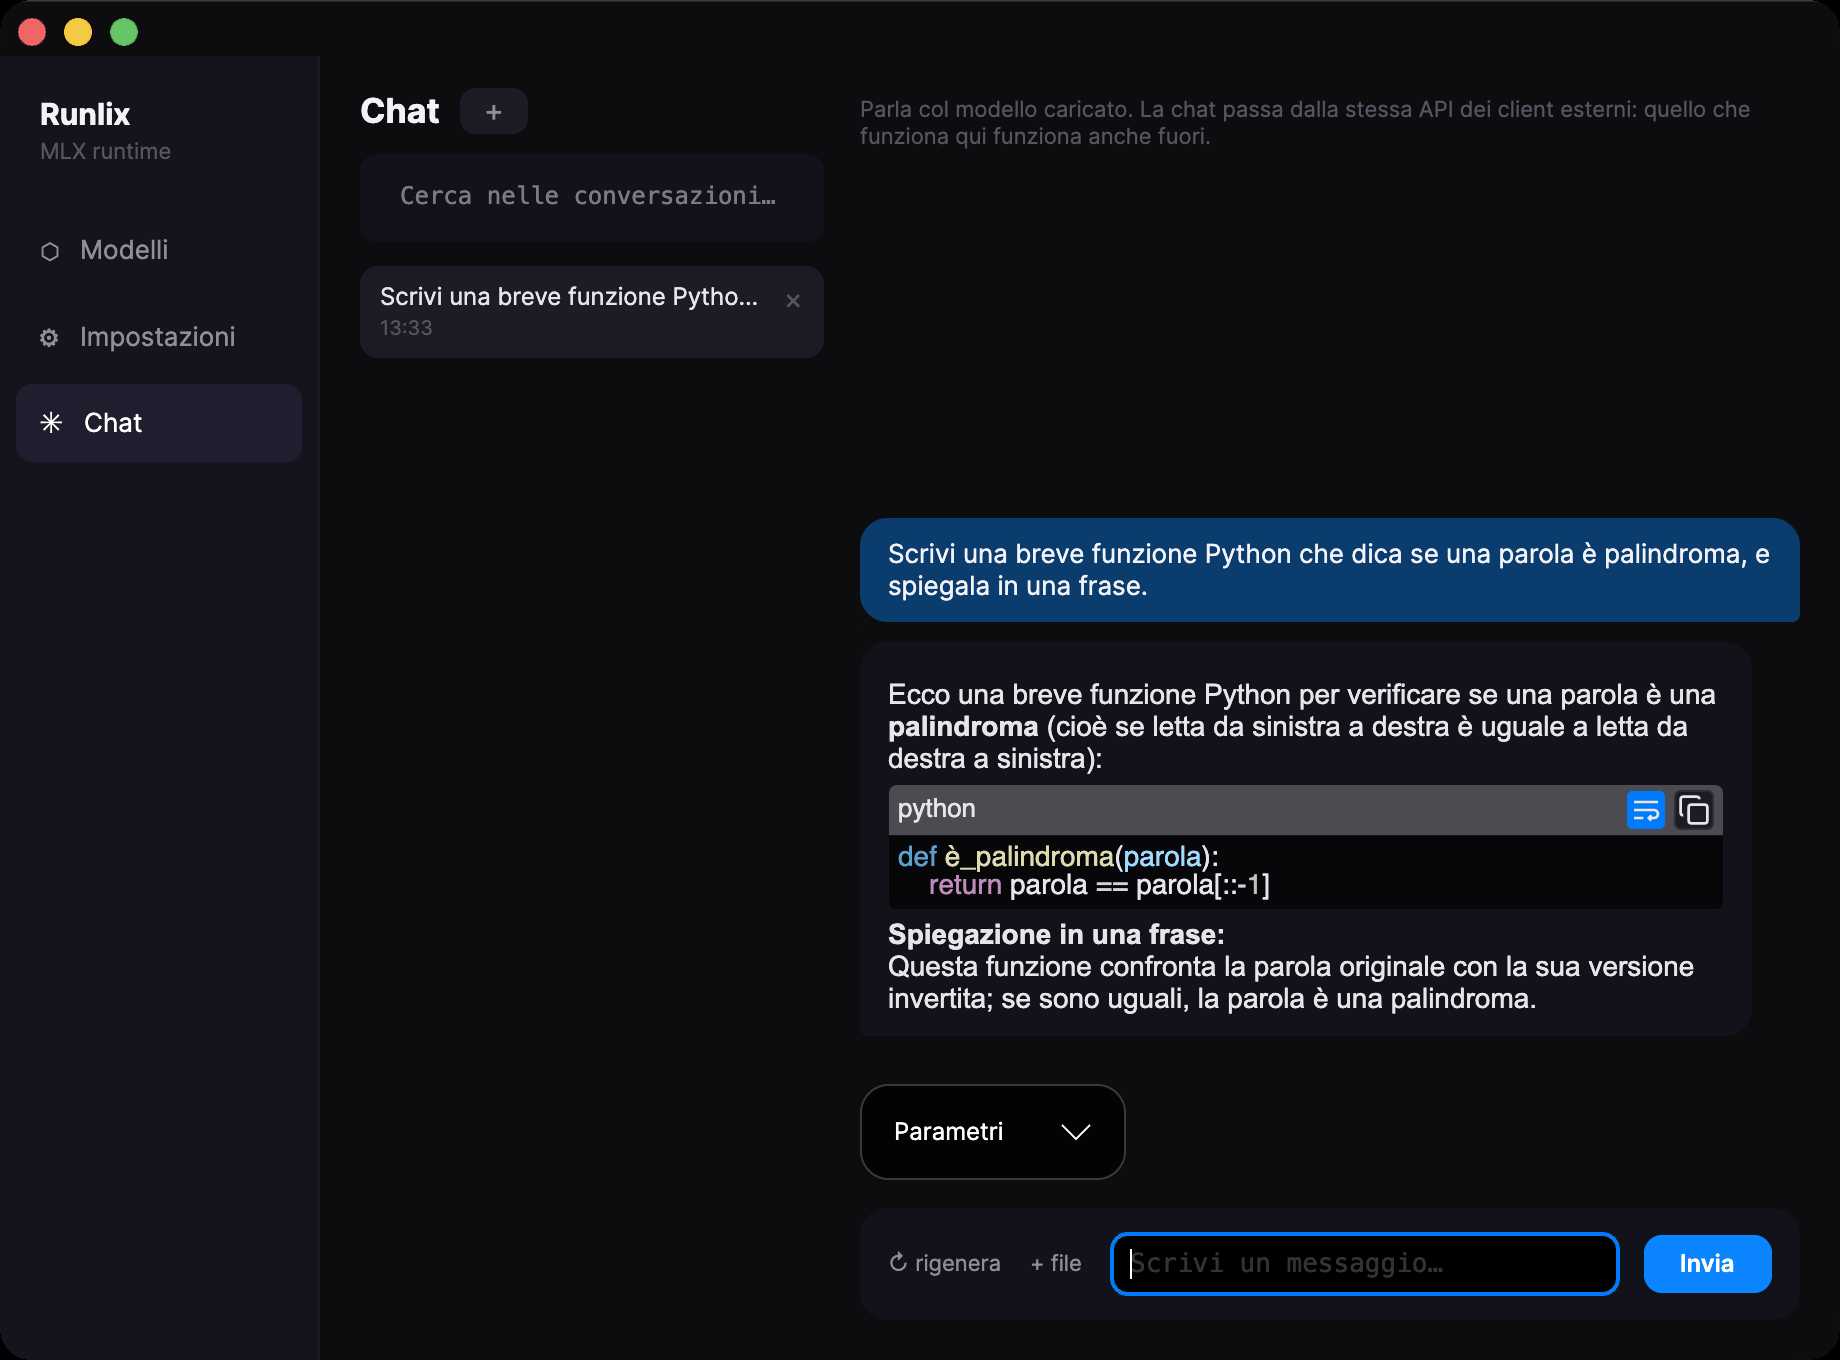
Quasi tutti i modi di far girare un modello in locale sono un kit da comporre: il motore di qua, la chat di là, il server da un'altra parte, e una cartella di scaricati che gestisci tu. Runlix è quelle quattro cose in un'applicazione sola, e il motore sotto è suo.
Il motore
Un motore Rust su MLX. I modelli si caricano nello stesso processo: niente Python in tutta l'app, nessun server da avviare prima.
Sei famiglie, verificate →La chat
Conversazioni che si ritrovano mesi dopo, allegati di testo, e strumenti via MCP: il modello può chiamare qualcosa e leggerne la risposta.
Come funzionano gli strumenti →Il server
Un'API HTTP su localhost, compatibile con OpenAI e con Ollama. Editor e script che parlano già con l'uno o con l'altro la puntano e funzionano.
Cosa ci si collega davvero →I modelli
Cerchi nel catalogo di Hugging Face e sai se un modello parte prima di scaricarlo. I download in coda riprendono da dove erano.
Il verdetto di compatibilità →Te lo dice prima di scaricare, non dopo
Scaricare otto gigabyte per scoprire che il modello non si carica è l'esperienza normale
dell'AI in locale. Runlix lo chiede prima a Hugging Face, legge il config.json del modello, e
dà un verdetto con la ragione scritta accanto.
mlx-lm la
conosce, quindi si può aggiungere.
config.json. Non saperlo si dice, non si indovina.
Scioglie anche gli alias, che è la parte su cui si inciampa: in MLX mistral è un altro nome di
llama, quindi un modello Mistral gira sul motore nativo anche se dal nome non si direbbe.
Runlix lo scrive nel verdetto invece di lasciartelo scoprire.
Misurato contro mlx-lm, non dichiarato
Il motore genera token identici a mlx_lm — verificato contro oracoli generati da mlx_lm
stesso, non guardando l'uscita a occhio. La velocità è un rapporto contro lo stesso riferimento,
e ogni rapporto porta la data in cui è stato preso.
Riferimento: mlx-lm = 100%. Misurato il 7 settembre 2026 su Llama-3.2-1B a 4 bit. La velocità su una macchina condivisa varia fra un giro e l'altro: questi sono i numeri di una sessione, non il caso migliore.
Più lento del riferimento, quindi — e detto. Il motore esiste per girare in-process ed essere
nostro, non per battere mlx_lm nella sua stessa aritmetica.
Per chi è
Tre tipi di persone vogliono la stessa cosa per ragioni diverse. Il sito è scritto per tutti e tre, invece di far finta che siano uno solo.
Costruisci con i modelli
Le parti interessanti sono il motore e il server: un runtime che puoi leggere, token verificati contro un riferimento invece che a occhio, e un endpoint a cui il tuo editor e i tuoi script puntano senza scrivere un adattatore.
Sei curioso, sul tuo Mac
Stanco di scegliere fra una scheda del browser e una riga di comando. Un'applicazione sola con dentro una chat e un catalogo che ti dice cosa girerà prima che tu spenda il download.
Alcune cose non possono uscire dal tuo Mac
I documenti di un cliente, gli appunti di un paziente, un fascicolo. Qui l'argomento non è la velocità: nessun account, nessuna telemetria, nessuna segnalazione di crash, nessuna statistica d'uso, e la rete toccata solo quando cerchi un modello.
Cosa non c'è ancora, e cosa ti serve
Non c'è ancora
Runlix è alla versione 0.1.0 e non c'è niente da scaricare. L'applicazione è firmata ad-hoc e non notarizzata, quindi macOS si rifiuterà di aprirla finché non glielo permetti esplicitamente.
Legge safetensors nel formato MLX soltanto — niente GGUF, mai, che è una decisione e non una lacuna. Niente modelli di visione, per ora.
Gli strumenti girano nella chat di Runlix; attraverso l'API HTTP il modello restituisce le chiamate e le esegue il tuo programma.
Cosa ti serve
macOS 14 o successivo, su Apple Silicon. I Mac Intel sono fuori dall'orizzonte e lo resteranno: MLX gira sulla GPU Apple, e non esiste una versione di questo che funzioni senza.
Il disco è soprattutto una questione di modelli, più che dell'applicazione in sé.
La roadmap è la versione onesta di tutto questo, e rispecchia le tappe del progetto invece di essere scritta per il sito.