Runlix
Le moteur, le chat, le serveur. Une seule app.
Runlix exécute des modèles d'IA sur votre Mac : un moteur Rust maison sur MLX, un chat capable d'utiliser des outils, et un serveur auquel se branchent les autres programmes. macOS 14 et plus, Apple Silicon.
Mis à jour 2026-09-12Mesuré 2026-09-07
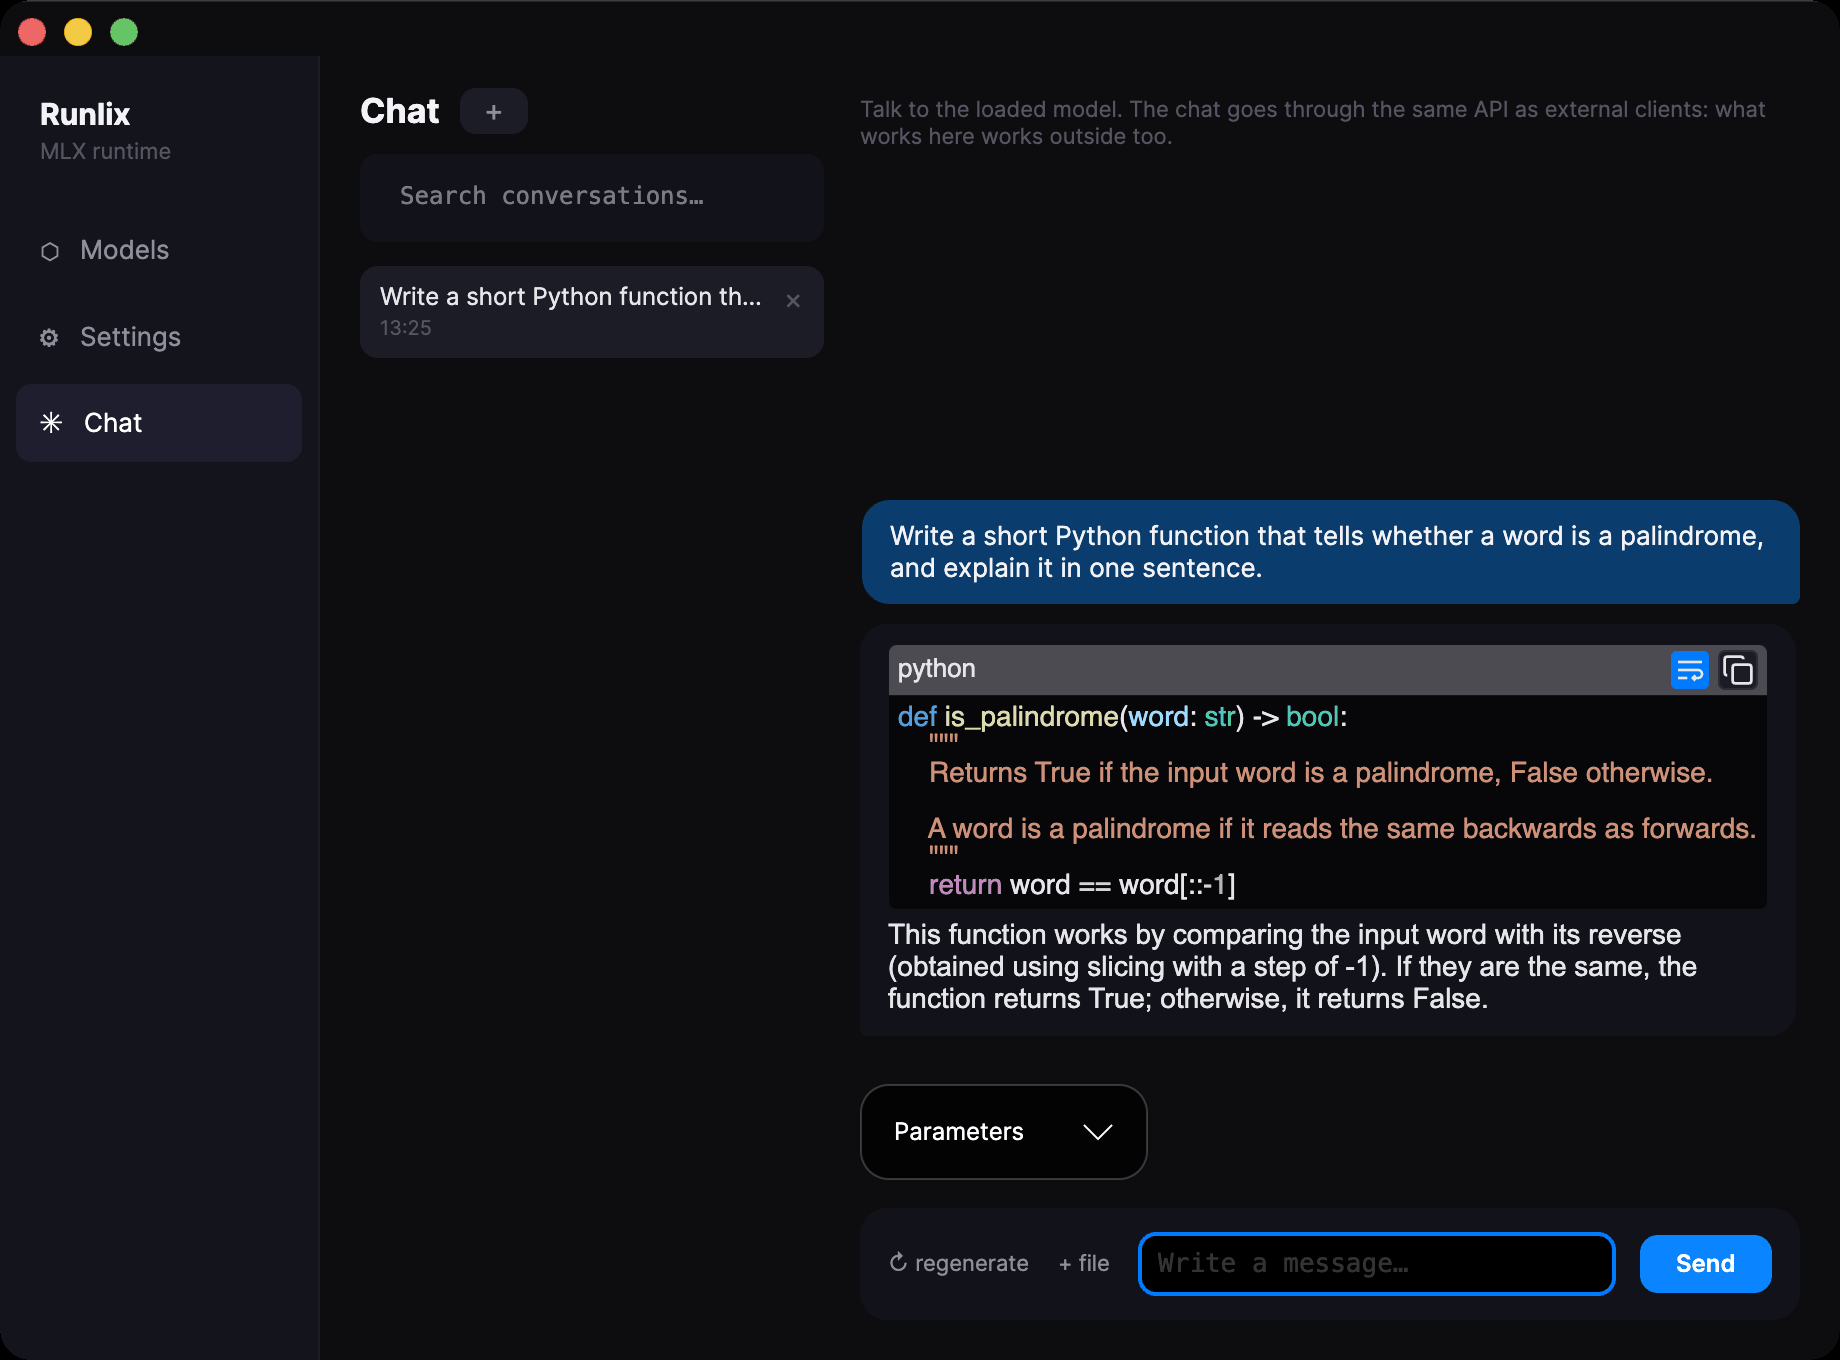
La plupart des façons d'exécuter un modèle en local sont un kit à assembler : le moteur ici, le chat là, le serveur ailleurs, et un dossier de téléchargements que vous gérez vous-même. Runlix est ces quatre choses dans une seule application, et le moteur en dessous est le sien.
Le moteur
Un moteur Rust sur MLX. Les modèles se chargent dans le même processus : pas de Python dans toute l'application, aucun serveur à démarrer d'abord.
Six familles de modèles, vérifiées →Le chat
Des conversations que vous retrouvez des mois plus tard, des pièces jointes en texte, et des outils via MCP : le modèle peut appeler quelque chose et en lire la réponse.
Comment fonctionnent les outils →Le serveur
Une API HTTP sur localhost, compatible avec OpenAI et avec Ollama. Les éditeurs et les scripts qui parlent déjà à l'un des deux pointent dessus et fonctionnent.
Ce qui s'y connecte vraiment →Les modèles
Chercher dans le catalogue Hugging Face et savoir si un modèle démarrera avant de le télécharger. Les téléchargements en file reprennent où ils s'étaient arrêtés.
Le verdict de compatibilité →Il vous le dit avant le téléchargement, pas après
Télécharger huit gigaoctets pour découvrir que le modèle ne se charge pas, c'est l'expérience
normale de l'IA en local. Runlix demande d'abord à Hugging Face, lit le config.json du modèle,
et rend un verdict avec la raison écrite à côté.
mlx-lm la
connaît, donc elle peut être ajoutée.
config.json. Ne pas savoir se dit, ne se devine pas.
Il résout aussi les alias, et c'est là que la plupart trébuchent : dans MLX, mistral est un
autre nom pour llama, donc un modèle Mistral tourne sur le moteur natif même si rien dans son
nom ne le laisse penser. Runlix l'écrit dans le verdict plutôt que de vous laisser le découvrir.
Mesuré contre mlx-lm, pas affirmé
Le moteur produit des tokens identiques à mlx_lm — vérifiés contre des oracles que mlx_lm
a lui-même engendrés, et non en regardant la sortie. La vitesse est un rapport à cette même
référence, et chaque rapport porte la date de sa mesure.
Référence : mlx-lm = 100 %. Mesuré le 7 septembre 2026 sur Llama-3.2-1B en 4 bits. Sur une machine partagée la vitesse varie d'un tour à l'autre : ce sont les chiffres d'une séance, pas le meilleur cas.
Plus lent que la référence, donc — et c'est dit. Le moteur existe pour tourner dans le processus et pour être le nôtre, pas pour battre en arithmétique la bibliothèque dont il est traduit.
À qui cela s'adresse
Trois sortes de gens veulent la même chose ici pour des raisons différentes. Le site est écrit pour les trois, au lieu de faire comme s'ils n'en formaient qu'une.
Vous construisez avec des modèles
Les parties intéressantes sont le moteur et le serveur : un runtime qu'on peut lire, des tokens vérifiés contre une référence plutôt qu'à l'œil, et un point d'accès sur lequel votre éditeur et vos scripts pointent sans écrire d'adaptateur.
Vous êtes curieux, sur votre Mac
Fatigué de choisir entre un onglet de navigateur et une ligne de commande. Une seule application avec un chat dedans et un catalogue qui vous dit ce qui tournera avant que vous dépensiez le téléchargement.
Certaines choses ne peuvent pas quitter votre Mac
Les documents d'un client, les notes d'un patient, un dossier. Ici l'argument n'est pas la vitesse : pas de compte, pas de télémétrie, pas de rapport de plantage, pas de statistique d'usage, et le réseau touché seulement quand vous cherchez un modèle.
Ce qui n'est pas encore là, et ce qu'il vous faut
Pas encore là
Runlix est en version 0.1.0 et il n'y a rien à télécharger. L'application est signée ad-hoc plutôt que notariée, donc macOS refusera de l'ouvrir tant que vous ne l'autoriserez pas explicitement.
Elle lit des safetensors au format MLX seulement — pas de GGUF, jamais, une décision et non un manque. Pas encore de modèles de vision.
Les outils tournent dans le chat de Runlix ; via l'API HTTP le modèle renvoie les appels et votre propre programme les exécute.
Ce qu'il vous faut
macOS 14 ou plus récent, sur Apple Silicon. Les Mac Intel sont hors du périmètre et le resteront : MLX tourne sur le GPU d'Apple, et il n'existe pas de version de ceci qui fonctionne sans.
Le disque est surtout une question de modèles, plutôt que de l'application elle-même.
La feuille de route est la version honnête de tout cela, et elle reflète les jalons du projet au lieu d'être écrite pour le site.