Runlix
El motor, el chat, el servidor. Una sola app.
Runlix ejecuta modelos de IA en tu Mac: un motor Rust propio sobre MLX, un chat que sabe usar herramientas, y un servidor al que se conectan los demás programas. macOS 14 y posteriores, Apple Silicon.
Actualizado 2026-09-12Medido 2026-09-07
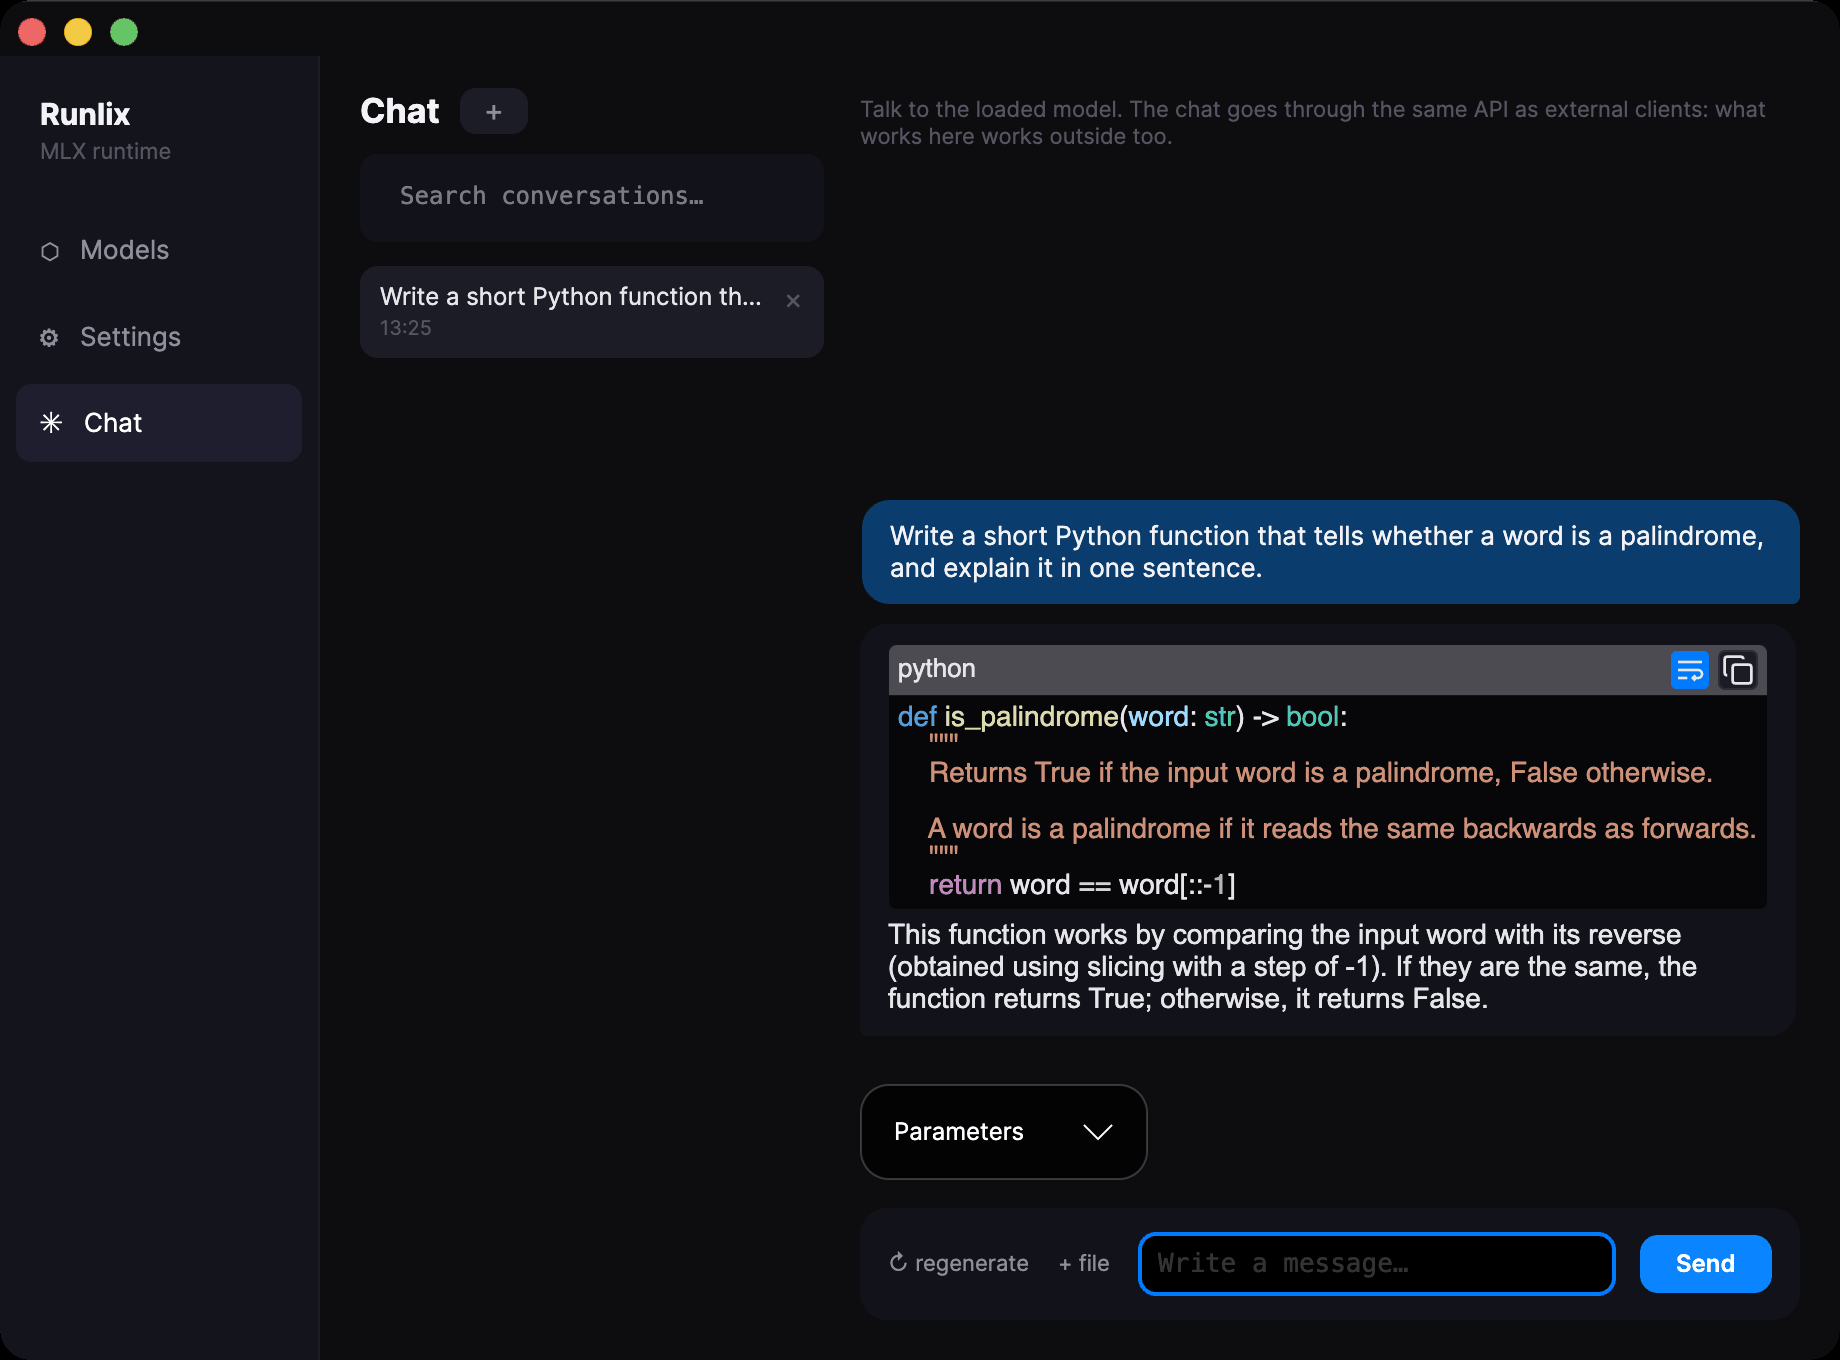
Casi todas las maneras de ejecutar un modelo en local son un kit por montar: el motor aquí, el chat allá, el servidor en otro sitio, y una carpeta de descargas que gestionas tú. Runlix es esas cuatro cosas en una sola aplicación, y el motor de debajo es suyo.
El motor
Un motor Rust sobre MLX. Los modelos se cargan en el mismo proceso: nada de Python en toda la aplicación, ningún servidor que arrancar antes.
Seis familias de modelos, verificadas →El chat
Conversaciones que reencuentras meses después, adjuntos de texto, y herramientas por MCP: el modelo puede llamar a algo y leer la respuesta.
Cómo funcionan las herramientas →El servidor
Una API HTTP en localhost, compatible con OpenAI y con Ollama. Los editores y los scripts que ya hablan con uno de los dos apuntan ahí y funcionan.
Qué se conecta de verdad →Los modelos
Buscar en el catálogo de Hugging Face y saber si un modelo arrancará antes de descargarlo. Las descargas en cola siguen donde se quedaron.
El veredicto de compatibilidad →Te lo dice antes de la descarga, no después
Descargar ocho gigabytes para descubrir que el modelo no carga es la experiencia normal de la IA
en local. Runlix se lo pregunta antes a Hugging Face, lee el config.json del modelo, y da un
veredicto con la razón escrita al lado.
mlx-lm la conoce, así
que se puede añadir.
config.json. No saberlo se dice, no se adivina.
También resuelve los alias, que es donde más gente tropieza: en MLX, mistral es otro nombre para
llama, así que un modelo Mistral corre en el motor nativo aunque su nombre no lo sugiera. Runlix
lo escribe en el veredicto en lugar de dejar que lo descubras tú.
Medido contra mlx-lm, no afirmado
El motor produce tokens idénticos a mlx_lm — verificados contra oráculos que el propio
mlx_lm ha generado, y no mirando la salida. La velocidad es una proporción respecto a esa misma
referencia, y cada proporción lleva la fecha de su medición.
Referencia: mlx-lm = 100 %. Medido el 7 de septiembre de 2026 en Llama-3.2-1B a 4 bits. En una máquina compartida la velocidad varía entre una vuelta y otra: estos son los números de una sesión, no el mejor caso.
Más lento que la referencia, entonces — y se dice. El motor existe para correr dentro del proceso y para ser nuestro, no para ganarle en aritmética a la biblioteca de la que está traducido.
Para quién es
Tres tipos de personas quieren lo mismo aquí por razones distintas. El sitio está escrito para los tres, en vez de fingir que son uno.
Construyes con modelos
Las partes interesantes son el motor y el servidor: un runtime que puedes leer, tokens verificados contra una referencia en vez de a ojo, y un endpoint al que tu editor y tus scripts apuntan sin escribir un adaptador.
Tienes curiosidad, en tu Mac
Cansado de elegir entre una pestaña del navegador y una línea de comandos. Una sola aplicación con un chat dentro y un catálogo que te dice qué va a funcionar antes de que gastes la descarga.
Algunas cosas no pueden salir de tu Mac
Los documentos de un cliente, las notas de un paciente, un expediente. Aquí el argumento no es la velocidad: sin cuenta, sin telemetría, sin informes de fallos, sin estadísticas de uso, y la red tocada solo cuando buscas un modelo.
Lo que todavía no está, y lo que necesitas
Todavía no está
Runlix está en la versión 0.1.0 y no hay nada que descargar. La aplicación está firmada ad-hoc y no notarizada, así que macOS se negará a abrirla hasta que se lo permitas explícitamente.
Lee safetensors solo en formato MLX — nada de GGUF, nunca, que es una decisión y no una carencia. Todavía ningún modelo de visión.
Las herramientas funcionan en el chat de Runlix; a través de la API HTTP el modelo devuelve las llamadas y las ejecuta tu propio programa.
Lo que necesitas
macOS 14 o posterior, en Apple Silicon. Los Mac Intel están fuera del alcance y lo seguirán estando: MLX funciona sobre la GPU de Apple, y no existe una versión de esto que funcione sin ella.
El disco es sobre todo una cuestión de modelos, más que de la aplicación en sí.
La hoja de ruta es la versión honesta de todo esto, y refleja los hitos del proyecto en vez de estar escrita para el sitio.