Ingeniería
Te lo dice antes de la descarga, no después
Buscar en el catálogo de Hugging Face desde Runlix, obtener un veredicto motivado sobre si un modelo arrancará de verdad, encolar descargas que siguen donde se quedaron, y ver adónde ha ido el disco.
Actualizado 2026-09-12Medido 2026-09-12
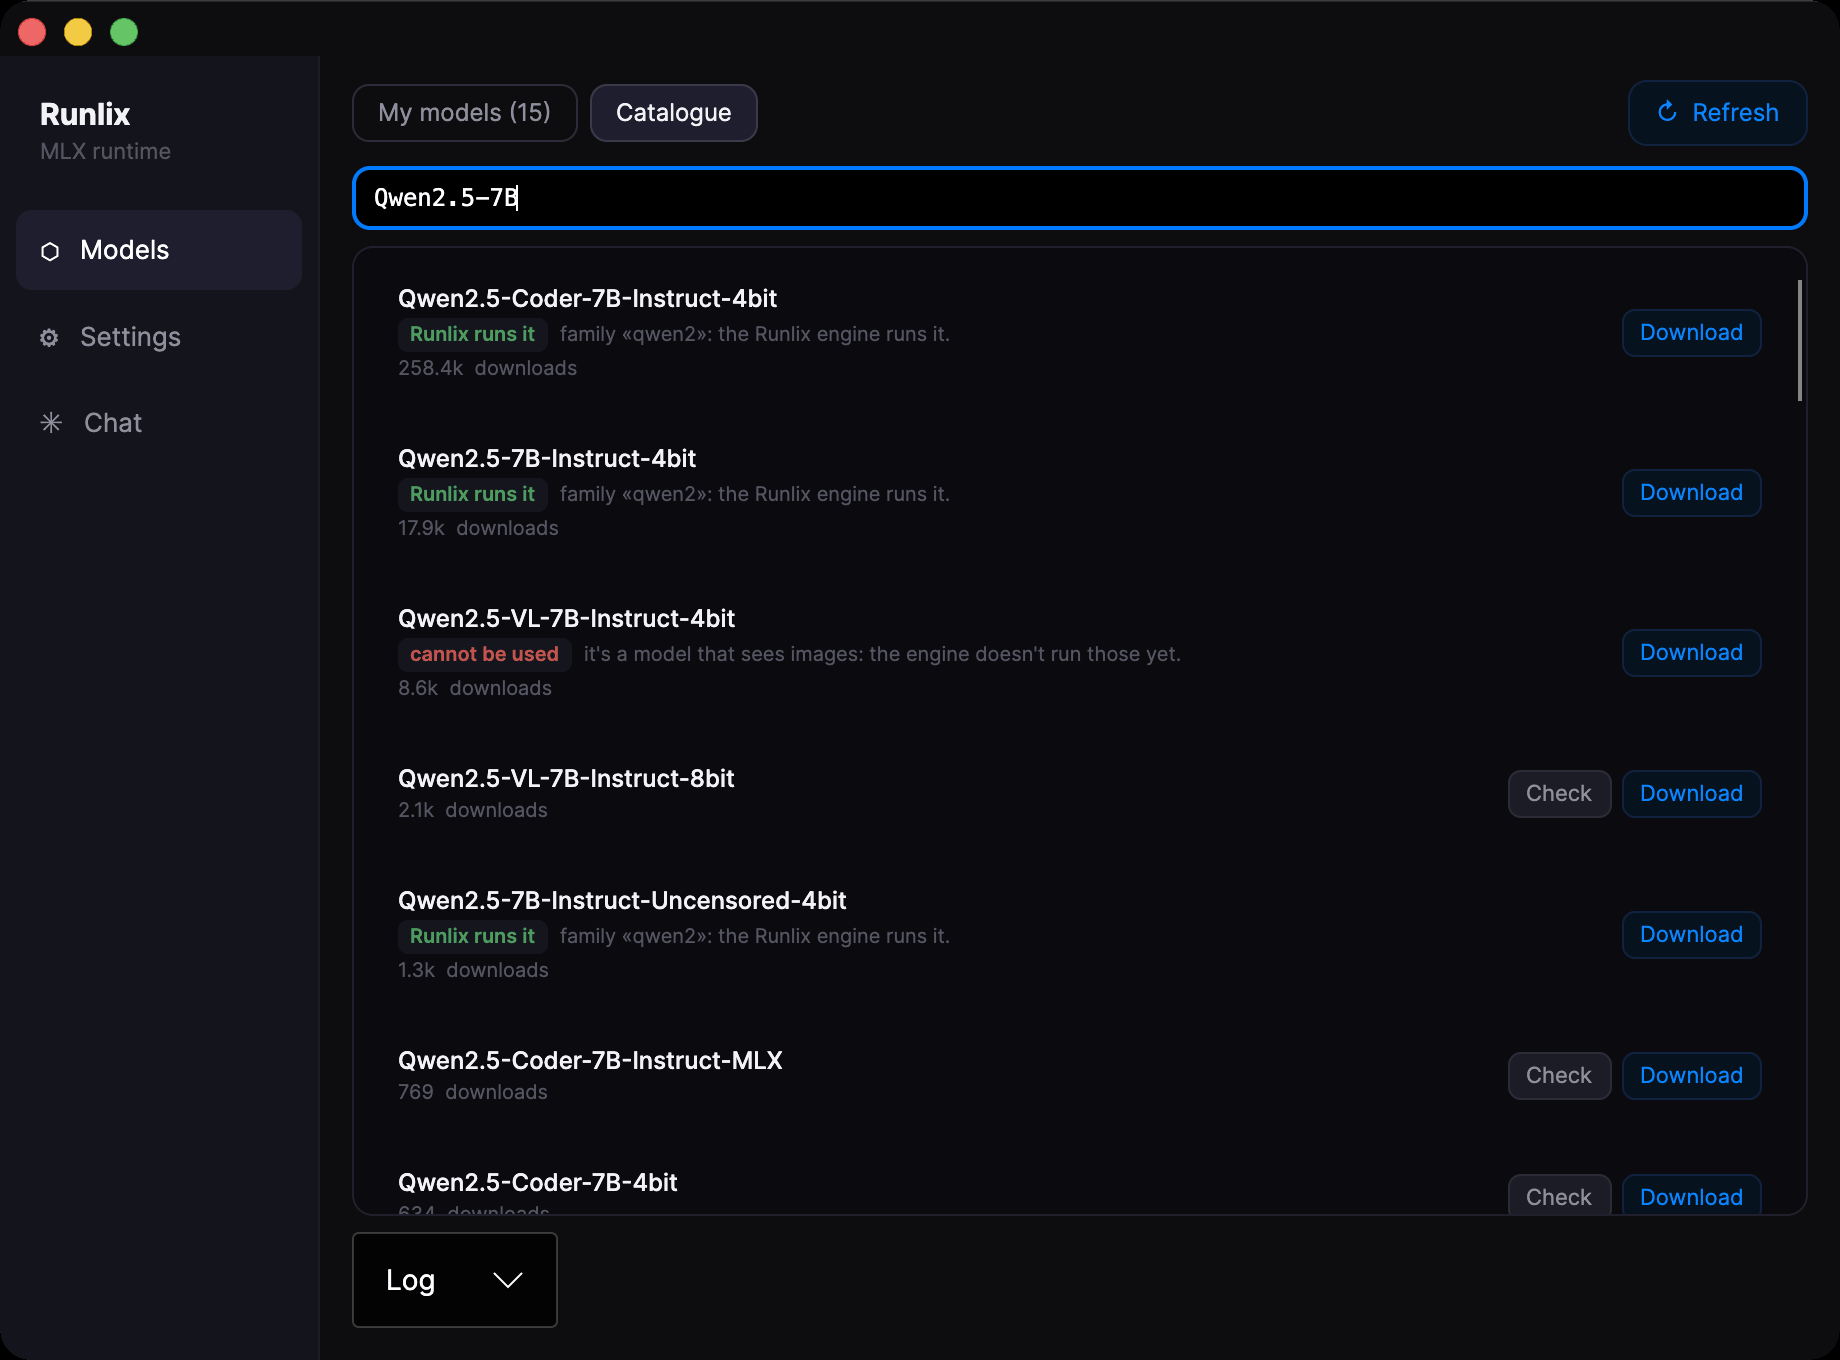
La manera normal de descubrir que un modelo no corre en tu máquina es descargarlo primero. Ocho gigabytes, veinte minutos, y luego un mensaje de error que nombra un campo de un archivo de configuración que no has abierto nunca.
Runlix lo pregunta antes. Lee la descripción que el modelo da de sí mismo en Hugging Face, sin descargar un byte de los pesos, y te da un veredicto con la razón escrita al lado.
mlx-lm la conoce, así
que es una familia que se puede añadir.
Las comprobaciones van en un orden, y cuenta. Los modelos de visión se detectan antes de mirar
la familia, porque gemma3 y qwen2_5_vl tienen un model_type que se parece al de un modelo de
solo texto: mirar la familia primero los dejaría pasar. Los alias se resuelven leyendo la tabla de
correspondencias de mlx-lm en lugar de una lista escrita a mano, y así mistral vuelve como
«otro nombre para llama» en vez de «desconocido». Y la lista detrás del «todavía no» son
literalmente los nombres de archivo de la copia congelada de mlx-lm que se guarda en el proyecto —
así que es correcta por construcción, en lugar de ser una lista que alguien tiene que acordarse de
actualizar.
«No se sabe» es un veredicto aparte a propósito. Un entorno de ejecución que adivina cuando no puede saber acabará adivinando mal, con seguridad.
La comprobación arranca cuando la pides, fila a fila, porque hacerla para una lista que recorres en un segundo serían cuatrocientas peticiones de red para nada.
El catálogo, buscado donde vive
La búsqueda corre del lado de Hugging Face, no sobre una página de resultados guardada en caché. La versión anterior cogía los primeros quinientos modelos y los filtraba en local, lo que significaba en silencio que todo lo que quedaba fuera de esa ventana no existía para la aplicación.
Cada fila muestra el modelo, una línea de detalles tomada de su propia descripción — phi3 · 4 bits · 40 capas · contexto 16k — cuánta gente lo ha descargado, y una insignia verde con el
tamaño si ya lo tienes.
Descargas que sobreviven a la interrupción
Las descargas pasan por una cola, dos a la vez. No más: el descargador ya paraleliza los archivos dentro de un repositorio, y apilar más solo parte el mismo ancho de banda en rebanadas más finas.
Cada una muestra una barra, la fase, y el detalle que de verdad te dice si conviene esperar:
12/47 archivos · 3,2 GB / 8,1 GB · 45,2 MB/s · 1m 52s. La velocidad es una media suavizada,
porque la instantánea oscila demasiado para leerse. Desplegar una descarga lista los archivos del
repositorio por tamaño, con una marca en los terminados.
Detén una y los archivos parciales se quedan en el disco. Vuélvela a encolar y sigue donde estaba — no empieza de cero. También puedes encolar una descarga de algo que no está en el catálogo, y así se repara un modelo que el catálogo no lista.
Qué significa «completo» exactamente
Una descarga está terminada cuando está cada fragmento que nombra el índice del modelo — no cuando la carpeta deja de crecer, ni cuando ha aparecido cierto número de archivos.
Una versión anterior lo adivinaba por el recuento de archivos, que es erróneo en los dos sentidos: un modelo pequeño con dos archivos parecía incompleto, y uno grande cuya descarga murió a dos piezas del final parecía listo. Preguntarle al modelo de qué piezas está hecho es la única respuesta que aguanta en ambos casos, y se comprueba una versión cada vez para que dos descargas a medias de versiones distintas no parezcan un modelo terminado.
El mismo cuidado explica por qué la cifra del disco cuenta los archivos reales y no los accesos directos que apuntan a ellos: los accesos contarían dos veces un archivo compartido entre dos versiones.
Adónde ha ido el disco
Las cachés de modelos crecen de una forma difícil de ver, y la mayor parte del crecimiento no son los modelos.
Runlix muestra 12,3 GB en disco · 8 modelos, contados a partir de los archivos que están de
verdad, y aparte lo que puedes recuperar: las revisiones distintas de main, dejadas por las actualizaciones y por las
referencias de las solicitudes de fusión, más los restos de descargas interrumpidas. En una caché
real había una sola revisión vieja que valía 2,27 GB.
La recuperación declara los bytes liberados. Cuando no hay nada que recuperar lo dice, en lugar de aparentar que ha trabajado.
Después de la descarga
«Use» abre un chat con el modelo que acabas de descargar, ya elegido. Parece lo mínimo que puede hacer un botón, y fue lo primero que rompió la primera prueba desde la imagen de instalación: el chat construía su lista de modelos una sola vez, al arrancar, así que un modelo descargado después no estaba. Ahora la lista se vuelve a leer en los dos momentos en que alguien la mira.
Un modelo cargado sigue cargado mientras la aplicación está abierta. No hay un temporizador que lo descargue a tus espaldas, porque la pregunta siguiente pagaría la recarga. Cuando quieres recuperar la memoria, los Ajustes tienen un botón que la libera — y de verdad: soltar los modelos no basta, porque MLX guarda lo que usaban en una reserva propia, así que el botón la vacía también y devuelve la memoria al Mac. Un modelo que está respondiendo en ese momento se queda donde está.
Lo que cuesta un modelo se mide sobre sus pesos. La caché de Hugging Face guarda los modelos como enlaces a un almacén de archivos; medir el enlace en lugar del archivo al que apunta hacía que cada modelo pareciera de unos pocos bytes, y el mecanismo que decide qué descargar para hacer sitio nunca encontraba un motivo para hacerlo. Ahora sigue los enlaces.
El filtro de formatos
Muchos repositorios publican el mismo modelo en varios formatos, y casi ninguno lo carga un motor
de Runlix. En bge-m3 la copia ONNX por sí sola son 2,29 GB de 6,86.
En los Ajustes hay cuatro casillas — ONNX, TensorFlow, Flax/JAX, TensorFlow Lite — y lo que
excluyen se salta en las descargas futuras. Los pesos de PyTorch deliberadamente no se pueden
filtrar: en ciertos modelos el .bin es lo único publicado, y un filtro capaz de dejar un modelo
sin poder descargarse lo hará.
Lo que ya está en el disco no se toca. El ajuste registra qué formatos están activos, para que un formato añadido el año que viene arranque excluido en vez de colarse en silencio.
La ficha, y las dos cosas que deciden si es agradable
Leer una ficha sin dejarse engañar
Las fichas las escribe gente contenta con su modelo, lo cual está bien, y no están escritas para decirte si cargará.
Ignora el número de parámetros del nombre y mira los tamaños de archivo: el mismo modelo de 7B existe como 15 GB a 16 bits, 8 GB a 8 y 4 GB a 4, y el nombre es idéntico en los tres casos.
Y mira lo que el repositorio contiene de verdad, no lo que la ficha describe: es habitual que describa el modelo original mientras el repositorio guarda una conversión.
Buscar sin martillear, y el token
Escribir en el buscador no dispara una petición por tecla: hay una pausa breve antes de que salga la consulta, así que una palabra de cinco letras es una petición y no cinco. Pequeño, y es la diferencia entre un catálogo en el que puedes escribir y otro que te limita por usarlo con normalidad.
El token de Hugging Face es opcional: sube los límites de frecuencia de la API y permite descargar modelos privados. Está en el llavero de macOS y no en la base de ajustes, y la aplicación lo lee una vez por arranque — lo retiene una caché en memoria, porque en una compilación firmada ad-hoc cada lectura es una petición de contraseña del sistema, y una por arranque ya es una más de las que quiere nadie.