Ingegneria
Te lo dice prima del download, non dopo
Cerchi nel catalogo di Hugging Face da dentro Runlix, ottieni un verdetto motivato su se un modello parte davvero, metti in coda download che riprendono da dove erano, e vedi dov'è finito il disco.
Aggiornato 2026-09-12Misurato 2026-09-12
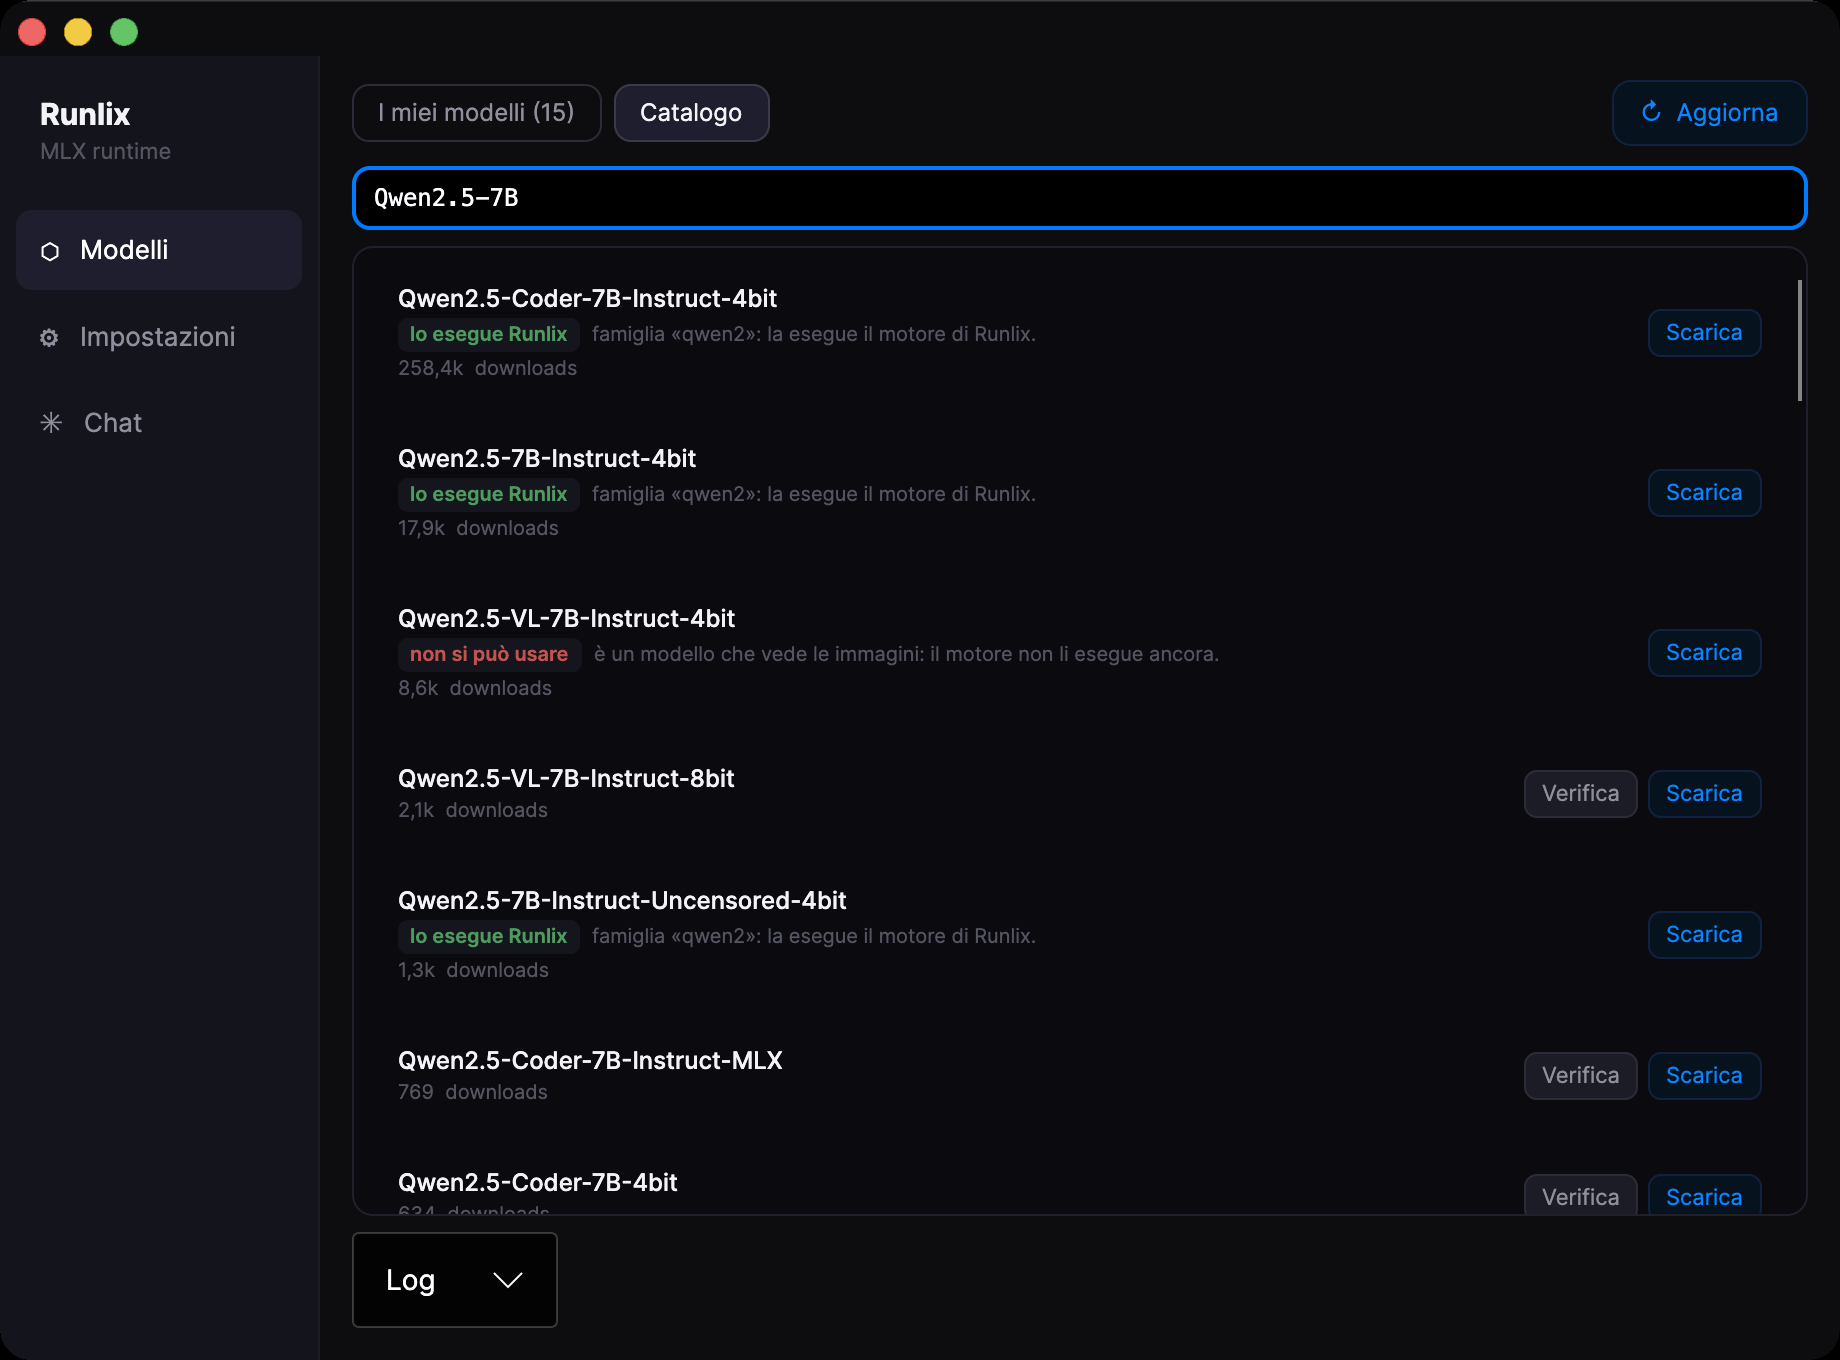
Il modo normale di scoprire che un modello non gira sulla tua macchina è scaricarlo prima. Otto gigabyte, venti minuti, e poi un messaggio d'errore che nomina un campo di un file di configurazione che non hai mai visto.
Runlix lo chiede prima. Legge la descrizione che il modello dà di sé su Hugging Face, senza scaricare un byte dei pesi, e ti dà un verdetto con la ragione scritta accanto.
mlx-lm la
conosce, quindi è una famiglia che si può aggiungere.
I controlli girano in un ordine che conta. I modelli di visione si riconoscono prima che si
guardi la famiglia, perché gemma3 e qwen2_5_vl hanno un model_type che somiglia a quello di
un modello di solo testo: guardare prima la famiglia li farebbe passare. Gli alias si sciolgono
leggendo la tabella di rimappatura di mlx-lm invece di un elenco scritto a mano, ed è così che
mistral torna come «un altro nome di llama» invece che come «sconosciuto». E l'elenco dietro il
«non ancora» sono letteralmente i nomi dei file nella copia congelata di mlx-lm tenuta nel
progetto — quindi è giusto per costruzione, invece di essere una lista che qualcuno si
deve ricordare di aggiornare.
«Non lo so» è un verdetto a sé apposta. Un motore che indovina quando non può sapere è un motore che prima o poi indovinerà male, con sicurezza.
Il controllo parte quando lo chiedi, una riga per volta, perché farlo per un elenco che scorri in un secondo sarebbero quattrocento richieste di rete per niente.
Il catalogo, cercato dove vive
La ricerca gira dalla parte di Hugging Face, non su una pagina di risultati tenuta in cache. La versione precedente prendeva i primi cinquecento modelli e li filtrava in locale, il che voleva dire in silenzio che tutto ciò che stava fuori da quella finestra, per l'applicazione, non esisteva.
Ogni riga mostra il modello, una riga di dettagli presa dalla sua descrizione — phi3 · 4 bit · 40 livelli · contesto 16k — quante persone l'hanno scaricato, e un badge verde con la dimensione
se ce l'hai già.
Download che sopravvivono all'interruzione
I download passano da una coda, due per volta. Non di più: lo scaricatore già parallelizza i file dentro un repository, e impilarne altri sopra divide la stessa banda in fette più sottili.
Ognuno mostra una barra, la fase, e il dettaglio che davvero ti dice se conviene aspettare:
12/47 file · 3,2 GB / 8,1 GB · 45,2 MB/s · 1m 52s. La velocità è una media smorzata, perché
quella istantanea oscilla troppo per leggersi. Espandendo un download si vedono i file del
repository ordinati per dimensione, con la spunta su quelli finiti.
Ne fermi uno e i file parziali restano sul disco. Lo rimetti in coda e riprende da dov'era — non ricomincia. Puoi anche accodare un download per qualcosa che nel catalogo non c'è affatto, ed è così che si ripara un modello che il catalogo non elenca.
Se un modello sia completo non si indovina contando quanti file sono arrivati. Runlix legge l'elenco che il modello stesso pubblica dei pezzi di cui è fatto, e li pretende tutti — per una versione sola per volta, così che due download a metà di versioni diverse non possano sembrare un modello finito.
Dov'è finito il disco
Le cache dei modelli crescono in un modo difficile da vedere, e gran parte della crescita non sono i modelli.
Runlix mostra 12,3 GB su disco · 8 modelli, contati dai file che ci sono davvero, e a parte
mostra cosa puoi riprenderti: le revisioni diverse da main, lasciate lì dagli aggiornamenti e
dai riferimenti delle pull request, più i residui dei download interrotti. In una cache vera
c'era una sola revisione vecchia che valeva 2,27 GB.
Il recupero dichiara i byte liberati. Quando non c'è niente da recuperare lo dice, invece di sembrare di aver lavorato senza fare niente.
Cosa vuol dire «completo»
Un download è finito quando c'è ogni shard che l'indice del modello nomina — non quando la cartella smette di crescere, e non quando è comparso un certo numero di file.
Una versione precedente lo indovinava dal conteggio dei file, che è sbagliato in tutti e due i versi: un modello piccolo con due file sembrava incompleto, e uno grande il cui download era morto a due pezzi dalla fine sembrava a posto. Chiedere al modello di quali pezzi è fatto è l'unica risposta che regge in entrambi i casi.
È la stessa cura per cui il dato sul disco conta i file veri e non le scorciatoie che li indicano: le scorciatoie conterebbero due volte lo stesso file quando due versioni lo condividono, e il numero sarebbe sbagliato nella direzione che fa sembrare il tuo disco peggio di com'è.
Dopo il download
«Usa» apre una chat col modello appena scaricato, già scelto. Sembra il minimo che un bottone possa fare, ed è la prima cosa che il primo collaudo dal disco d'installazione ha rotto: la chat costruiva l'elenco dei modelli una volta sola, all'avvio, quindi un modello scaricato dopo non c'era. Adesso l'elenco si rilegge nei due momenti in cui qualcuno lo guarda.
Un modello caricato resta caricato finché l'app è aperta. Non c'è un timer che lo scarica alle tue spalle, perché la domanda dopo pagherebbe il ricaricamento. Quando rivuoi la memoria, nelle Impostazioni c'è un bottone che la libera — e la libera davvero: lasciare i modelli non basta, perché MLX tiene quello che usavano in un suo serbatoio, quindi il bottone svuota anche quello e restituisce la memoria al Mac. Il modello che sta rispondendo in quel momento resta dov'è.
Quanto costa un modello si misura sui suoi pesi. La cache di Hugging Face tiene i modelli come collegamenti a un archivio di file; misurare il collegamento invece del file a cui punta faceva sembrare ogni modello di pochi byte, e il meccanismo che decide cosa scaricare per fare spazio non trovava mai un motivo per farlo. Adesso segue i collegamenti.
Il filtro dei formati
Molti repository pubblicano lo stesso modello in più formati, e quasi nessuno di quelli lo carica
un motore di Runlix. Su bge-m3 la sola copia ONNX è 2,29 GB su 6,86.
Nelle Impostazioni ci sono quattro caselle — ONNX, TensorFlow, Flax/JAX, TensorFlow Lite — e ciò
che escludono viene saltato sui download futuri. I pesi PyTorch deliberatamente non si possono
filtrare: per certi modelli il .bin è l'unica cosa pubblicata, e un filtro che può rendere un
modello non scaricabile è un filtro che lo farà.
Quello che è già sul disco non si tocca. L'impostazione registra quali formati sono attivi, così un formato aggiunto l'anno prossimo parte escluso invece di infilarsi dentro in silenzio.
Due cose piccole che decidono se è piacevole
Cercare senza martellare
Scrivere nella casella di ricerca non spara una richiesta per tasto: c'è una breve pausa prima che la domanda parta, quindi una parola di cinque lettere è una richiesta e non cinque.
Piccola cosa — e la differenza fra un catalogo in cui puoi scrivere e uno che ti mette a tetto per averlo usato normalmente.
Il gettone di Hugging Face
Facoltativo. Alza i limiti di frequenza e permette di scaricare modelli privati.
Sta nel portachiavi di macOS e non nel database delle impostazioni, e si legge una volta per avvio: ogni lettura ti chiede la password su una build firmata ad-hoc, e una per avvio è già una più di quante ne voglia chiunque.