Technik
Es sagt es vor dem Download, nicht danach
Den Hugging-Face-Katalog aus Runlix heraus durchsuchen, ein begründetes Urteil darüber bekommen, ob ein Modell wirklich läuft, Downloads einreihen, die dort weitermachen wo sie standen, und sehen wohin der Speicherplatz ging.
Aktualisiert 2026-09-12Gemessen 2026-09-12
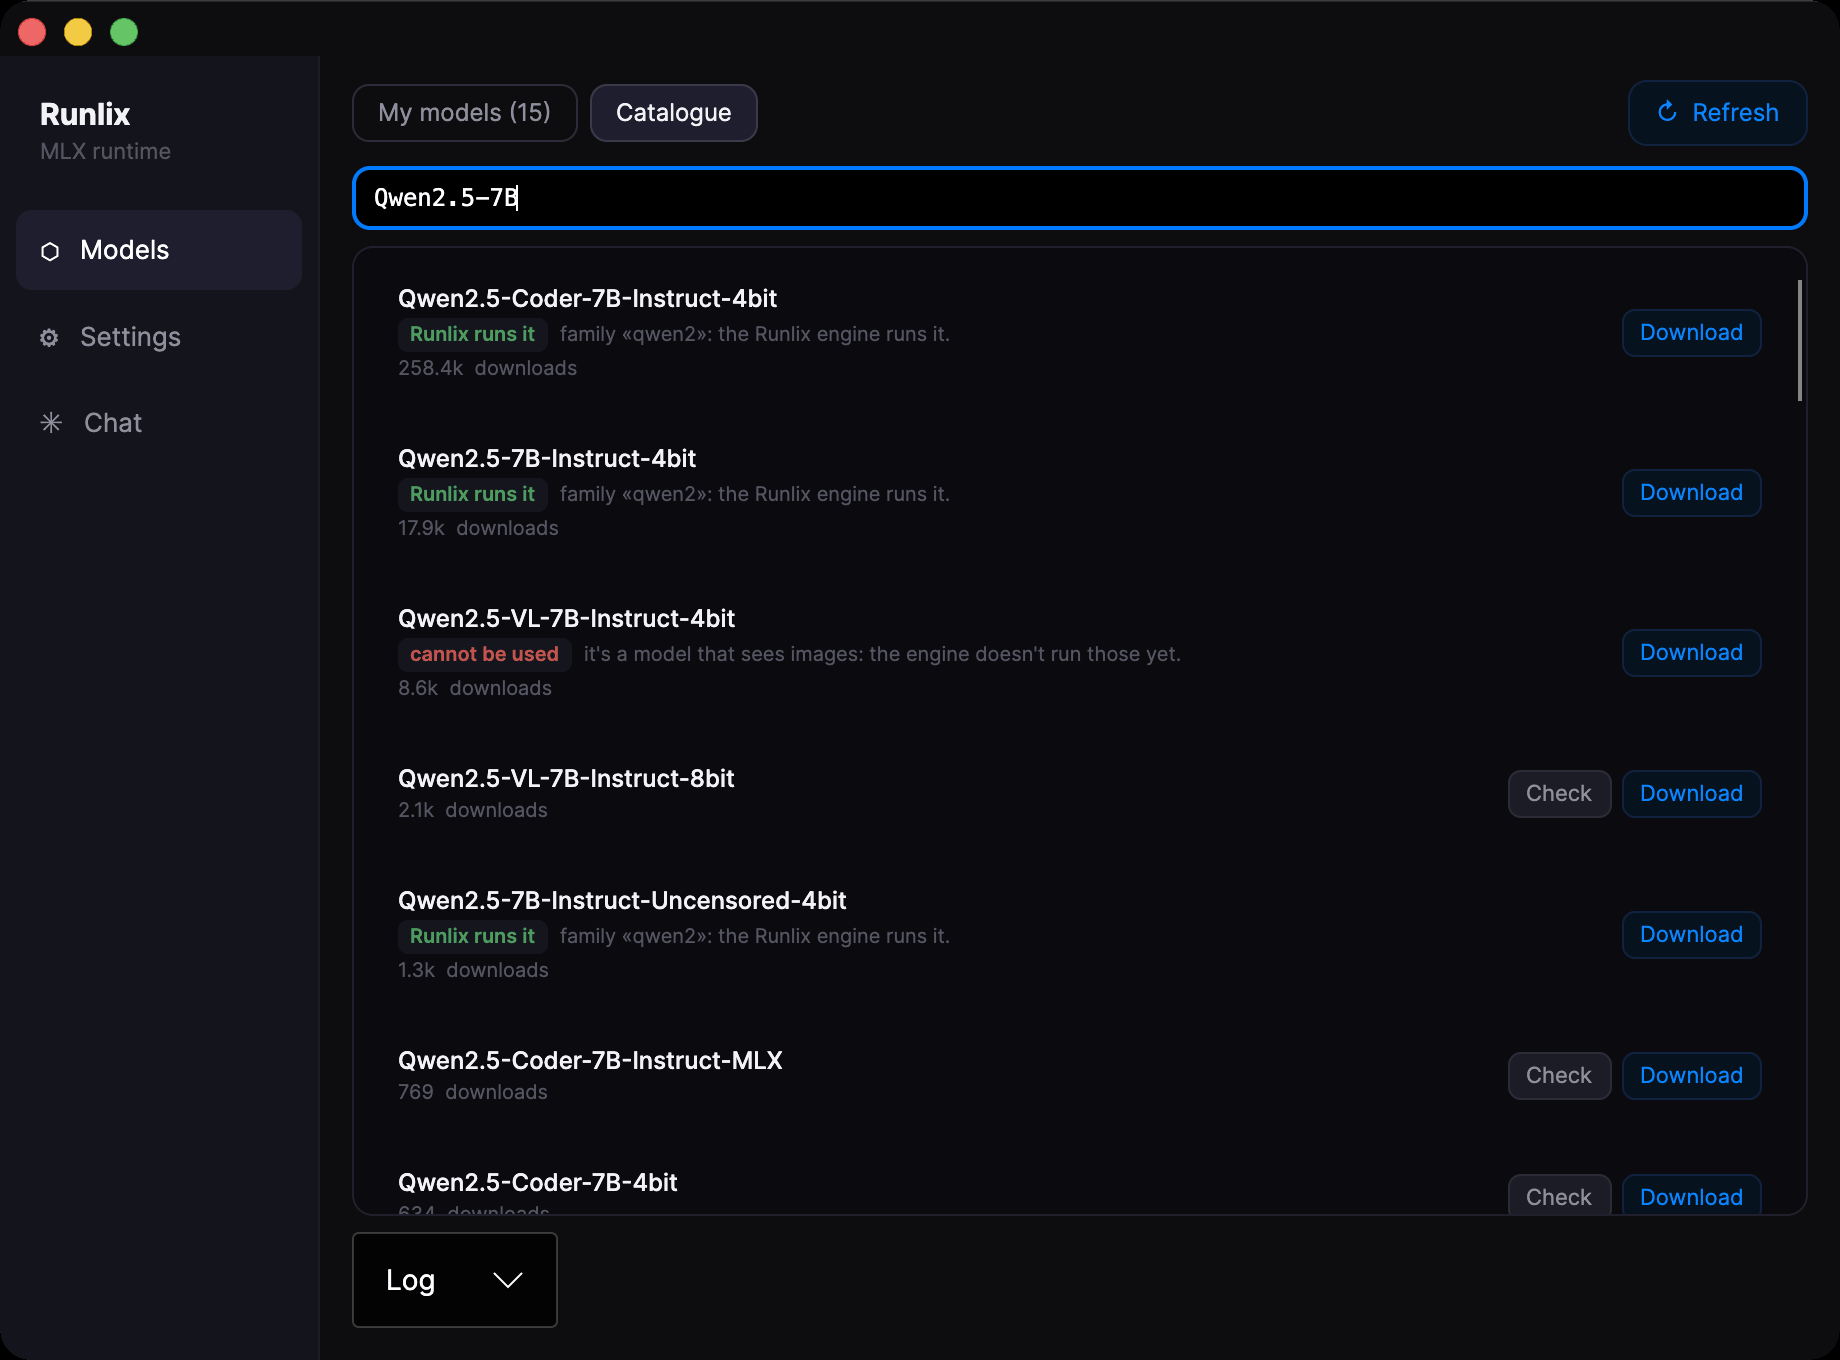
Der normale Weg herauszufinden, dass ein Modell auf Ihrer Maschine nicht läuft, ist, es zuerst herunterzuladen. Acht Gigabyte, zwanzig Minuten, und dann eine Fehlermeldung, die ein Feld in einer Konfigurationsdatei nennt, die Sie nie geöffnet haben.
Runlix fragt vorher. Es liest die Beschreibung, die das Modell auf Hugging Face von sich selbst gibt, ohne ein Byte der Gewichte zu laden, und gibt Ihnen ein Urteil mit dem Grund daneben.
mlx-lm kennt
sie, also ist es eine Familie, die sich hinzufügen lässt.
Die Prüfungen laufen in einer Reihenfolge, und die zählt. Vision-Modelle werden erkannt,
bevor die Familie nachgeschlagen wird, weil gemma3 und qwen2_5_vl einen model_type
haben, der wie der eines Textmodells aussieht: zuerst die Familie zu prüfen würde sie
durchwinken. Aliasnamen werden aus der Umbenennungstabelle von mlx-lm aufgelöst statt aus einer
von Hand geschriebenen Liste, und so kommt mistral als „ein anderer Name für llama“ zurück
statt als „unbekannt“. Und die Liste hinter dem „noch nicht“ sind buchstäblich die Dateinamen
in der eingefrorenen Kopie von mlx-lm, die im Projekt liegt — sie ist also durch
Konstruktion richtig, statt eine Liste zu sein, an deren Pflege sich jemand erinnern muss.
„Nicht bekannt“ ist absichtlich ein eigenes Urteil. Eine Laufzeitumgebung, die rät, wenn sie es nicht wissen kann, wird irgendwann falsch raten, und zwar mit Überzeugung.
Die Prüfung läuft, wenn Sie sie verlangen, Zeile für Zeile — sie für eine Liste laufen zu lassen, durch die Sie in einer Sekunde scrollen, wären vierhundert Netzanfragen für nichts.
Der Katalog, dort durchsucht wo er wohnt
Die Suche läuft auf Seiten von Hugging Face, nicht über eine zwischengespeicherte Ergebnisseite. Die frühere Fassung holte die ersten fünfhundert Modelle und filterte lokal, was stillschweigend hieß, dass alles außerhalb dieses Fensters für die Anwendung nicht existierte.
Jede Zeile zeigt das Modell, eine Detailzeile aus seiner eigenen Beschreibung — phi3 · 4 Bit · 40 Schichten · Kontext 16k — wie viele Menschen es geladen haben, und ein grünes Abzeichen mit
der Größe, wenn Sie es schon haben.
Downloads, die eine Unterbrechung überleben
Downloads laufen über eine Warteschlange, zwei gleichzeitig. Nicht mehr: der Downloader parallelisiert die Dateien innerhalb eines Repositorys bereits, und mehr obendrauf teilt dieselbe Bandbreite nur in dünnere Scheiben.
Jeder zeigt einen Balken, die Phase, und das Detail, das Ihnen wirklich sagt, ob sich Warten
lohnt: 12/47 Dateien · 3,2 GB / 8,1 GB · 45,2 MB/s · 1m 52s. Die Geschwindigkeit ist ein
geglätteter Mittelwert, weil der Momentanwert zu schnell springt, um lesbar zu sein. Einen
Download aufzuklappen listet die Dateien des Repositorys nach Größe, mit einem Haken bei den
fertigen.
Halten Sie einen an, bleiben die Teildateien auf der Platte. Reihen Sie ihn wieder ein, macht er dort weiter, wo er stand — er fängt nicht von vorn an. Sie können auch einen Download für etwas einreihen, das gar nicht im Katalog steht, und so repariert man ein Modell, das der Katalog nicht führt.
Was „vollständig“ eigentlich heißt
Ein Download ist fertig, wenn jedes Stück da ist, das das Modell selbst aufzählt — nicht, wenn der Ordner aufhört zu wachsen, und nicht, wenn eine bestimmte Anzahl Dateien aufgetaucht ist.
Eine frühere Fassung zählte Dateien, was in beide Richtungen falsch ist: ein kleines Modell aus zwei Dateien sah unfertig aus, und ein großes, dessen Download zwei Stücke vor Schluss starb, sah fertig aus. Das Modell zu fragen, aus welchen Stücken es besteht, ist die einzige Antwort, die für beide Fälle hält — und geprüft wird eine Fassung nach der anderen, damit zwei halbe Downloads verschiedener Fassungen nicht wie ein fertiges Modell aussehen.
Dieselbe Sorgfalt ist der Grund, warum die Speicherplatzangabe die echten Dateien zählt und nicht die Verweise darauf: die Verweise würden dieselbe Datei doppelt zählen, wenn zwei Fassungen sie teilen.
Wohin der Speicherplatz ging
Modell-Caches wachsen auf eine Weise, die schwer zu sehen ist, und das meiste Wachstum sind nicht die Modelle.
Runlix zeigt 12,3 GB auf der Platte · 8 Modelle, aus den wirklich vorhandenen Dateien gezählt,
und getrennt davon, was Sie zurückbekommen können: Revisionen außer main, von Aktualisierungen und von Verweisen aus
Pull Requests liegen geblieben, plus die Reste abgebrochener Downloads. In einem echten Cache lag
eine einzelne alte Revision im Wert von 2,27 GB.
Das Zurückholen nennt die freigegebenen Bytes. Gibt es nichts zurückzuholen, sagt es das, statt so zu tun, als hätte es gearbeitet.
Nach dem Download
„Use“ öffnet einen Chat mit dem gerade geladenen Modell, schon ausgewählt. Das klingt nach dem Mindesten, was ein Knopf tun kann, und es war das Erste, was der erste Probelauf vom Installations-Image kaputtgemacht hat: Der Chat baute seine Modellliste einmal beim Start, ein danach geladenes Modell fehlte also. Jetzt wird die Liste in den zwei Momenten neu gelesen, in denen jemand sie ansieht.
Ein geladenes Modell bleibt geladen, solange die App offen ist. Es gibt keinen Zeitgeber, der es hinter Ihrem Rücken entlädt, denn die nächste Frage würde das Neuladen bezahlen. Wenn Sie den Speicher zurückwollen, gibt es in den Einstellungen einen Knopf, der ihn freigibt — und zwar wirklich: die Modelle loszulassen reicht nicht, weil MLX das, was sie belegten, in einem eigenen Vorrat behält, also leert der Knopf auch diesen und gibt den Speicher dem Mac zurück. Ein Modell, das gerade antwortet, bleibt, wo es ist.
Was ein Modell kostet, wird an seinen Gewichten gemessen. Der Cache von Hugging Face hält Modelle als Verknüpfungen in einen Dateispeicher; die Verknüpfung statt der Datei zu messen, auf die sie zeigt, ließ jedes Modell wie ein paar Bytes aussehen, und der Mechanismus, der entscheidet, was für Platz entladen wird, fand nie einen Grund dazu. Jetzt folgt er den Verknüpfungen.
Der Formatfilter
Viele Repositories veröffentlichen dasselbe Modell in mehreren Formaten, und fast keines davon
lädt eine Engine von Runlix. Bei bge-m3 ist allein die ONNX-Kopie 2,29 GB von 6,86.
In den Einstellungen stehen vier Kästchen — ONNX, TensorFlow, Flax/JAX, TensorFlow Lite — und was
sie ausschließen, wird bei künftigen Downloads übersprungen. PyTorch-Gewichte lassen sich
absichtlich nicht filtern: bei manchen Modellen ist die .bin das einzige Veröffentlichte, und
ein Filter, der ein Modell unherunterladbar machen kann, wird es tun.
Was schon auf der Platte liegt, wird nicht angerührt. Die Einstellung merkt sich, welche Formate aktiv sind, damit ein nächstes Jahr hinzugefügtes Format ausgeschlossen startet, statt sich stillschweigend hereinzuschleichen.
Das Urteil in der Zeile, und die Karte, die es nicht ersetzt
Warum es in der Zeile steht und nicht in einem Dialog
Die Prüfung läuft, während die Liste eintrifft, und ihr Ergebnis steht in derselben Zeile wie der Name — nicht hinter einem Klick.
Ein Urteil, das man erst öffnen muss, wird von niemandem geöffnet, und dann lädt man doch wieder acht Gigabyte herunter, um es hinterher zu erfahren.
Eine Modellkarte lesen, ohne sich täuschen zu lassen
Modellkarten schreiben Leute, die mit ihrem Modell zufrieden sind, was in Ordnung ist, und sie sind nicht dafür geschrieben, Ihnen zu sagen, ob es lädt.
Ignorieren Sie die Parameterzahl im Namen und schauen Sie auf die Dateigrößen: dasselbe 7B-Modell gibt es als 15 GB mit 16 Bit, 8 GB mit 8 und 4 GB mit 4, und der Name ist in allen drei Fällen derselbe.
Und schauen Sie darauf, was das Repository tatsächlich enthält, statt darauf, was die Karte beschreibt — häufig beschreibt eine Karte das Originalmodell, während das Repository eine Konvertierung hält.
Zwei Kleinigkeiten, die entscheiden, ob es angenehm ist
Suchen, ohne zu hämmern
Ins Suchfeld zu tippen löst nicht pro Tastendruck eine Anfrage aus: vor dem Absenden liegt eine kurze Pause, ein Wort mit fünf Buchstaben ist also eine Anfrage und nicht fünf.
Klein — und zugleich der Unterschied zwischen einem Katalog, in den man tippen kann, und einem, der einen dafür ausbremst, dass man ihn normal benutzt.
Das Hugging-Face-Token
Freiwillig. Es hebt die Ratenbegrenzung der API an und erlaubt, private Modelle zu laden.
Es liegt im Schlüsselbund von macOS und nicht in der Einstellungsdatenbank, und die Anwendung liest es einmal pro Start — ein Zwischenspeicher hält es, weil jede Lesung bei einem ad-hoc signierten Build eine Passwortabfrage des Systems ist, und eine pro Start ist schon eine mehr, als irgendwer will.