Runlix
Die Engine, der Chat, der Server. Eine App.
Runlix führt KI-Modelle auf Ihrem Mac aus: eine eigene Rust-Engine auf MLX, ein Chat, der Werkzeuge benutzen kann, und ein Server, an den sich andere Programme anschließen. macOS 14 und neuer, Apple Silicon.
Aktualisiert 2026-09-12Gemessen 2026-09-07
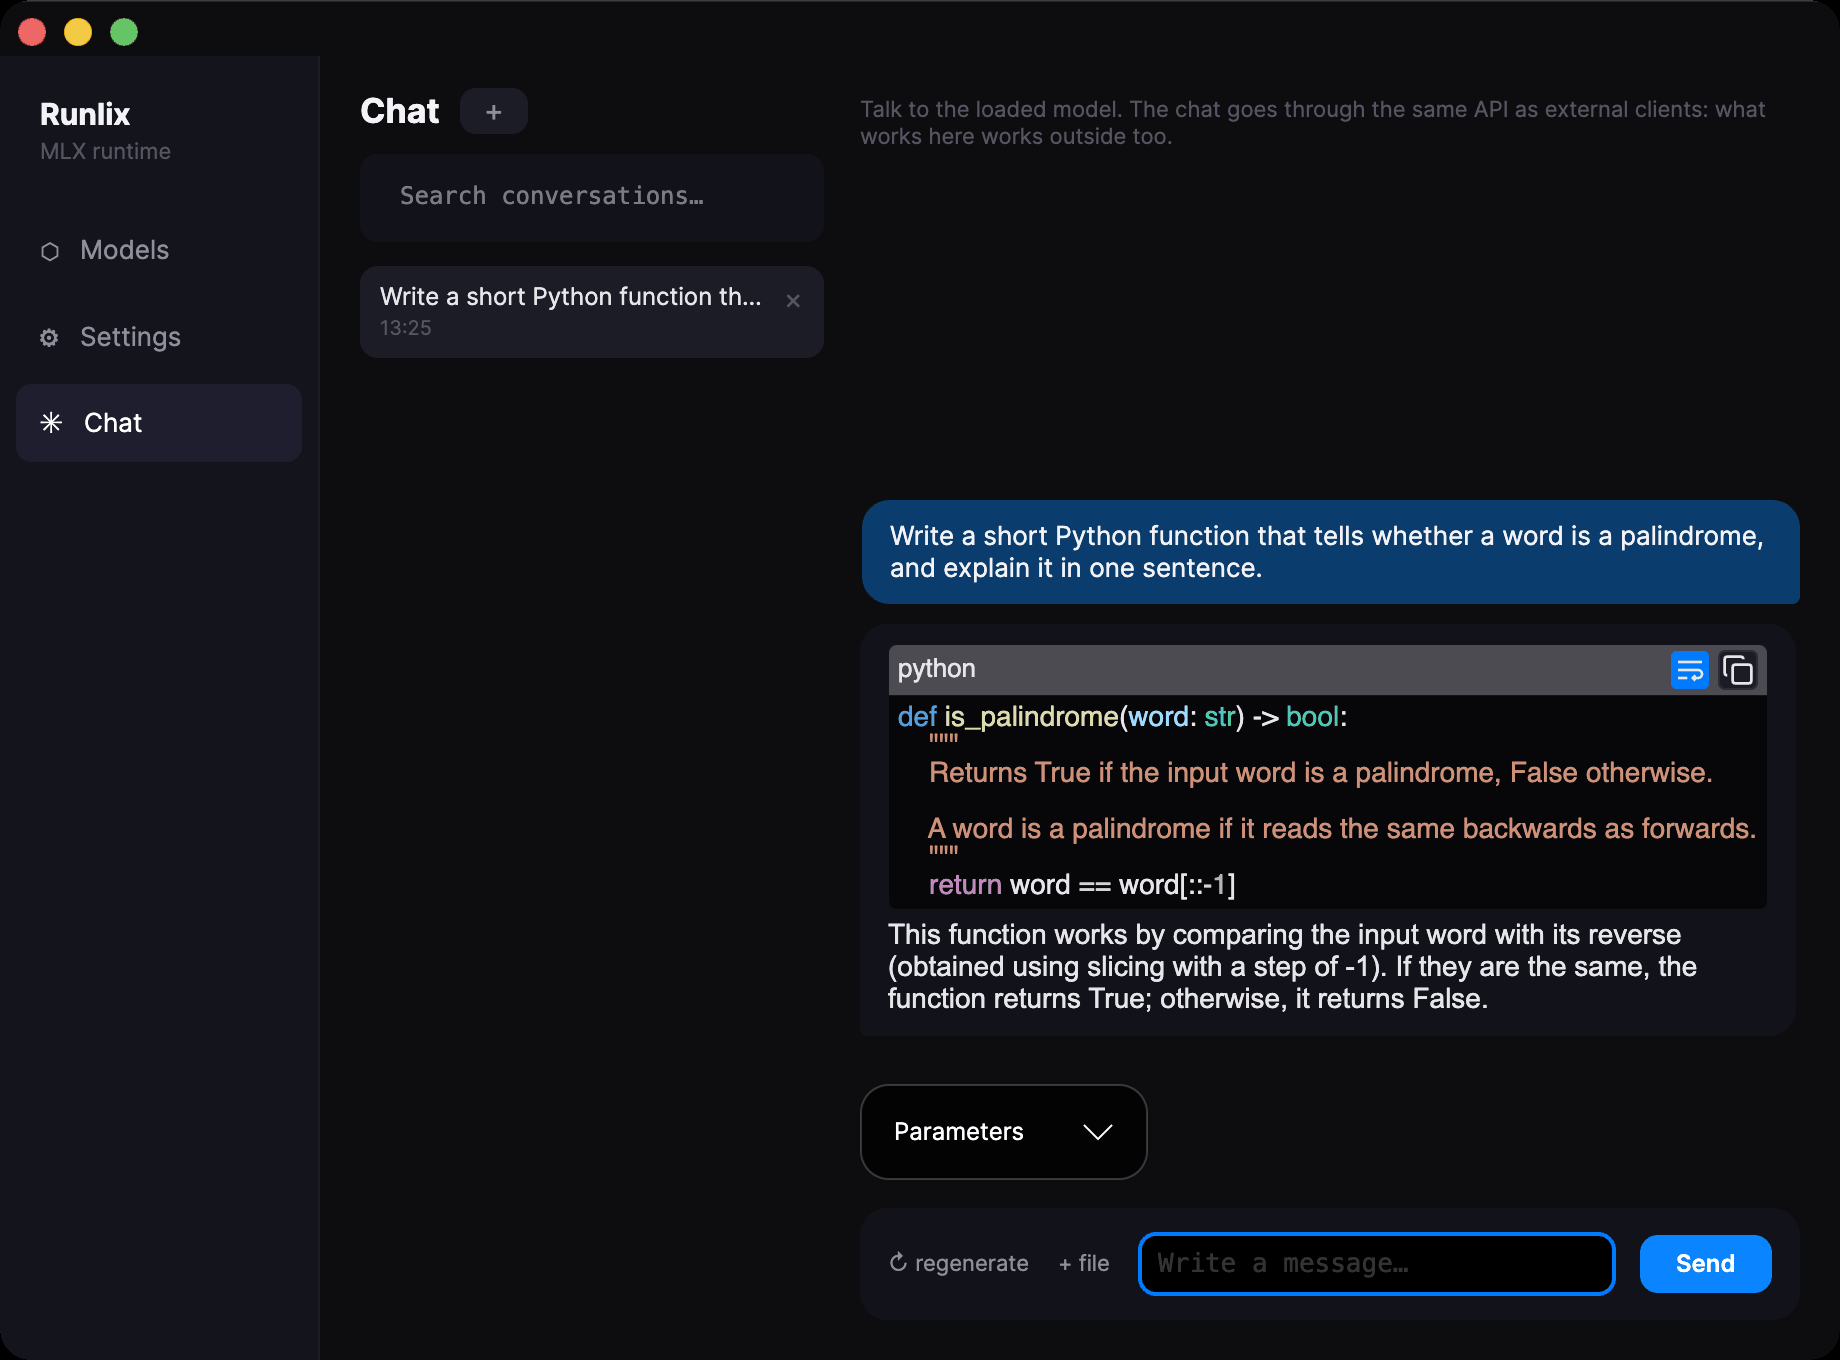
Die meisten Wege, ein Modell lokal auszuführen, sind ein Bausatz: die Engine hier, der Chat dort, der Server woanders, und ein Ordner voller Downloads, den Sie selbst verwalten. Runlix ist diese vier Dinge in einer einzigen Anwendung, und die Engine darunter ist die eigene.
Die Engine
Eine Rust-Engine auf MLX. Modelle werden im selben Prozess geladen — kein Python in der ganzen App, kein Server, der vorher starten muss.
Sechs Modellfamilien, geprüft →Der Chat
Unterhaltungen, die Sie Monate später wiederfinden, Textanhänge und Werkzeuge über MCP: das Modell kann etwas aufrufen und die Antwort lesen.
Wie Werkzeuge funktionieren →Der Server
Eine HTTP-API auf localhost, kompatibel mit OpenAI und mit Ollama. Editoren und Skripte, die schon mit einem von beiden sprechen, zeigen darauf und funktionieren.
Was sich wirklich verbindet →Die Modelle
Den Hugging-Face-Katalog durchsuchen und vor dem Download erfahren, ob ein Modell läuft. Downloads in der Warteschlange nehmen dort wieder auf, wo sie standen.
Das Kompatibilitätsurteil →Es sagt es Ihnen vor dem Download, nicht danach
Acht Gigabyte herunterzuladen, um festzustellen, dass das Modell nicht lädt, ist die normale
Erfahrung mit lokaler KI. Runlix fragt zuerst bei Hugging Face nach, liest die config.json des
Modells und gibt ein Urteil ab — mit dem Grund daneben.
mlx-lm kennt
sie, also lässt sie sich hinzufügen.
config.json. Nichtwissen wird gesagt, nicht geraten.
Es löst auch Aliasnamen auf, und daran scheitern die meisten: In MLX ist mistral ein anderer
Name für llama, ein Mistral-Modell läuft also auf der nativen Engine, obwohl der Name nichts
davon verrät. Runlix schreibt das ins Urteil, statt es Sie herausfinden zu lassen.
Gegen mlx-lm gemessen, nicht behauptet
Die Engine erzeugt Tokens, die identisch zu mlx_lm sind — geprüft gegen Orakel, die
mlx_lm selbst erzeugt hat, und nicht durch Betrachten der Ausgabe. Geschwindigkeit ist ein
Verhältnis zur selben Referenz, und jedes Verhältnis trägt das Datum seiner Messung.
Referenz: mlx-lm = 100 %. Gemessen am 7. September 2026 auf Llama-3.2-1B mit 4 Bit. Die Geschwindigkeit schwankt auf einer geteilten Maschine zwischen den Durchläufen: das sind die Zahlen einer Sitzung, nicht der beste Fall.
Also langsamer als die Referenz — und das wird gesagt. Die Engine existiert, um im Prozess zu laufen und uns zu gehören, nicht um die Bibliothek zu schlagen, aus der sie übersetzt wurde.
Für wen das ist
Drei Arten von Menschen wollen hier dasselbe aus verschiedenen Gründen. Die Website ist für alle drei geschrieben, statt so zu tun, als wären sie eine.
Sie bauen mit Modellen
Die interessanten Teile sind die Engine und der Server: eine Laufzeit, die man lesen kann, Tokens gegen eine Referenz geprüft statt nach Augenmaß, und ein Endpunkt, auf den Ihr Editor und Ihre Skripte ohne Adapter zeigen.
Sie sind neugierig, auf Ihrem Mac
Müde, zwischen einem Browser-Tab und einer Kommandozeile zu wählen. Eine Anwendung mit einem Chat darin und einem Katalog, der sagt, was läuft, bevor Sie den Download ausgeben.
Manches darf Ihren Mac nicht verlassen
Die Unterlagen eines Mandanten, die Notizen eines Patienten, eine Akte. Hier ist das Argument nicht Geschwindigkeit: kein Konto, keine Telemetrie, keine Absturzberichte, keine Nutzungsstatistik, und das Netz nur berührt, wenn Sie ein Modell suchen.
Was noch nicht da ist, und was Sie brauchen
Noch nicht da
Runlix ist Version 0.1.0 und es gibt nichts zum Herunterladen. Die Anwendung ist ad-hoc signiert statt notarisiert, macOS wird sie also nicht öffnen, bis Sie es ausdrücklich erlauben.
Sie liest safetensors nur im MLX-Format — kein GGUF, nie, eine Entscheidung und keine Lücke. Noch keine Bildmodelle.
Werkzeuge laufen im Runlix-Chat; über die HTTP-API gibt das Modell die Aufrufe zurück und Ihr eigenes Programm führt sie aus.
Was Sie brauchen
macOS 14 oder neuer, auf Apple Silicon. Intel-Macs sind außerhalb des Rahmens und bleiben es: MLX läuft auf der Apple-GPU, und es gibt keine Fassung davon, die ohne eine funktioniert.
Der Speicherplatz ist vor allem eine Frage der Modelle, nicht der Anwendung selbst.
Die Roadmap ist die ehrliche Fassung von all dem und spiegelt die Meilensteine des Projekts, statt für die Website geschrieben zu sein.