Ingegneria
Un endpoint, compatibile con OpenAI e con Ollama
Runlix serve un'API HTTP su 127.0.0.1, compatibile con l'API di OpenAI e con quella di Ollama: chat, completamenti ed embedding nativi. Editor, script e connettori che parlano già con l'una o con l'altra la puntano e funzionano.
Aggiornato 2026-09-18
Metà del valore di far girare un modello in locale è tutto il resto che a quel punto può usarlo: un'estensione dell'editor, uno script, un connettore dentro un altro programma. Tutti parlano uno di due protocolli. Runlix è compatibile con entrambi, dalla stessa porta, sugli stessi modelli — e non è Ollama, né ha bisogno che sia installato.
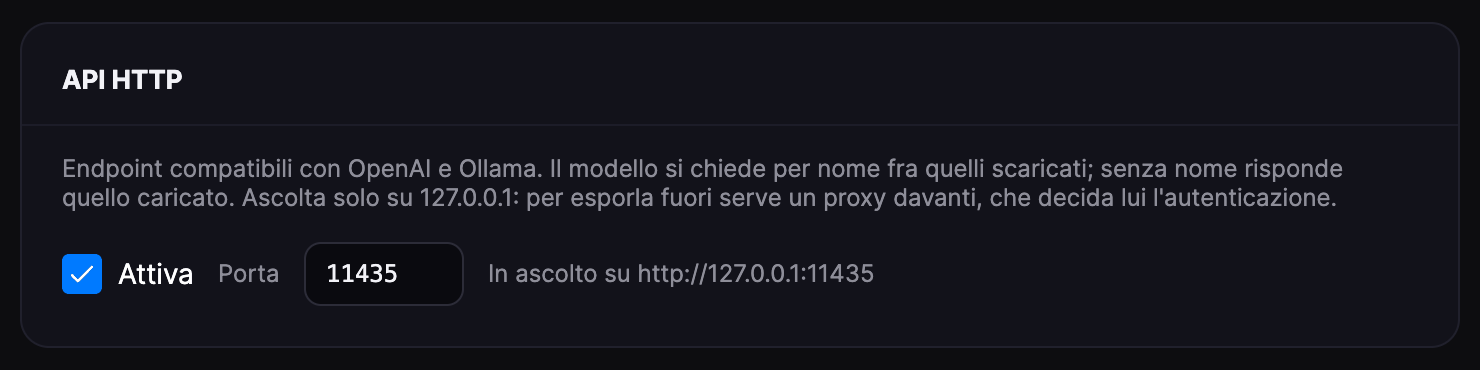
Si accende nelle Impostazioni, con la porta accanto all'interruttore. La predefinita è 11435, una sopra quella di Ollama, così che avere installati entrambi non sia una lite. Se la porta è occupata l'interruttore torna indietro e il motivo è scritto lì accanto, invece che il server semplicemente non ci sia.
finish_reason dice quello che
dice invece di essere una costante plausibile.
Cosa serve
| Percorso | Note | |
|---|---|---|
| GET | / |
Controllo di salute, risposto come se lo aspettano i client di Ollama |
| GET | /api/tags |
L'elenco dei modelli, forma Ollama |
| POST | /api/show |
Scheda del modello, che i client di Ollama chiedono prima di una chat |
| POST | /api/generate |
NDJSON in streaming, per impostazione predefinita |
| POST | /api/chat |
NDJSON; chiamate a strumenti nella forma di Ollama |
| GET | /v1/models |
Forma OpenAI |
| POST | /v1/chat/completions |
Eventi SSE; chiamate a strumenti nella forma di OpenAI |
| POST | /v1/embeddings |
Embedding nativi, forma OpenAI — anche su /embeddings |
I due protocolli non vanno d'accordo in modi che si vedono solo contro i client veri, e ognuno dei disaccordi qui sotto è costato una sessione di indagine.
Il controllo di salute non è decorazione: i client dell'API di Ollama lo chiedono prima di
qualunque altra cosa, e senza la risposta che si aspettano si fermano con «something went wrong».
/api/tags include un digest perché il client da riga di comando di Ollama lo tronca a dodici
caratteri senza controllare che ci sia e va in panic quando manca. /api/show legge sia
model sia name, perché quel client li manda tutti e due e ne lascia uno vuoto. Lo streaming ha
predefiniti diversi fra i due protocolli e ognuno segue la propria convenzione: NDJSON acceso per
Ollama, spento per OpenAI. Le chiamate a strumenti hanno forme diverse — arguments è un oggetto
in uno e una stringa nell'altro, e solo uno porta id e type.
Quindi: compatibile con l'API di Ollama per elencare, mostrare e chattare, provato contro il
client di Ollama stesso. Non per pull, push, create, copy, delete, ps, embed o
version — i modelli Runlix li scarica e li gestisce da sé. Qualunque client compatibile OpenAI
che abbia bisogno di /v1/chat/completions, /v1/models o /v1/embeddings funziona.
Cosa puoi davvero puntarci contro
Qualunque cosa parli uno dei due protocolli, che ormai è quasi tutto.
Le estensioni per editor che permettono di impostare un URL di base — Continue, Cline,
l'assistente di Zed, la modalità compatibile OpenAI di una dozzina d'altri — hanno bisogno di
/v1/chat/completions e /v1/models, e ci sono entrambi. Gli script che usano le librerie
ufficiali di OpenAI funzionano puntando l'URL di base a http://127.0.0.1:11435/v1 e passando una
stringa qualsiasi come chiave, visto che non c'è nessuna chiave da controllare. Qualunque cosa
parli già con Ollama trova gli endpoint che cerca, nelle forme che si aspetta, perché sono stati
provati contro il client da riga di comando di Ollama e non contro la documentazione.
La porta è una sopra quella di Ollama apposta. Se li tieni tutti e due, nessuno deve spostarsi, e un client configurato per uno non finirà in silenzio sull'altro rispondendo con un modello che non hai scelto.
Quello che ottieni è il modello che hai nominato, risolto fra quelli che hai scaricato. Nominane uno che non hai e l'errore dice quale nome ha fallito e che non è fra gli scaricati — non un quattrocento generico che ti lascia a confrontare stringhe a occhio. Non mandare nessun nome e ottieni il modello caricato, che è l'ultimo usato e non uno preso a caso.
Cosa ti risponde, e con quanta onestà
Errori che dicono quale sbaglio
Un metodo sbagliato su un percorso che esiste risponde 405, non 404. La differenza conta quando stai correggendo un client: 404 ti manda a cercare un refuso nell'indirizzo, 405 ti dice che l'indirizzo era giusto e il verbo no.
Una seconda generazione mentre una è in corso viene rifiutata invece che accodata. Accodare vorrebbe dire un'attesa imprevedibile senza modo di sapere quanto, e per un server locale a un utente solo un rifiuto che puoi riprovare è più utile di una promessa che potrebbe prendere quattro minuti.
Numeri contati
usage viene dal motore — prompt, completamento, totale. Non dedotto dai
caratteri, che è la scorciatoia abituale ed è sbagliata di una quantità diversa per ogni
lingua.
Anche finish_reason si legge dal motore, quindi length vuol dire
che la risposta è stata davvero tagliata e non è una costante che sembrava plausibile.
I parametri di campionamento si leggono sia in cima sia dentro options, perché
i client di Ollama li mettono lì, e si applicano a ogni richiesta partendo
dai valori di riposo veri del motore, così niente trapela da chi ha chiamato prima.
Manda un seed e due richieste identiche danno due risposte identiche. Senza,
variano, come deve fare un modello — un seme assente resta assente invece di diventare zero
in silenzio.
Chiudi la connessione a metà e la generazione si ferma. Onestamente: non all'istante — si ferma quando il buffer di scrittura si riempie e il socket lancia.
Streaming, nei due dialetti
I due protocolli mandano il flusso in modo diverso e ognuno tiene la propria convenzione, perché un client scritto per uno si aspetta quella e nient'altro.
I client OpenAI ricevono eventi SSE: righe data: che portano ognuna un pezzo di JSON,
un'identità sola condivisa da tutti i pezzi della stessa risposta, e un data: [DONE] finale. I
client Ollama ricevono oggetti JSON separati da un a capo, uno per riga, con l'ultimo che porta i
conteggi. Entrambi arrivano a pezzi, così le prime parole compaiono mentre il resto si sta ancora
generando.
Un'eccezione, ed è voluta: quando ci sono di mezzo gli strumenti, il flusso trattiene. Mezza chiamata JSON che arriva a pezzi non serve a nessun client che ne abbia mai consumata una, quindi la decisione si manda intera o non si manda.
Solo localhost, e nessuna autenticazione
Il server si lega a 127.0.0.1 e a nient'altro. Non c'è un gettone, non c'è una password, non
c'è un utente.
È una decisione più che una dimenticanza. L'autenticazione che conta è quella che qualcuno mantiene, e una casella «richiedi una chiave» su una socket di loopback fornisce soprattutto la sensazione di averne una. Se ti serve raggiungibile da altrove, mettici davanti un proxy e lascia decidere a lui chi entra — è il pezzo che quel mestiere lo sa già fare.
Gli embedding, dallo stesso motore
/v1/embeddings trasforma il testo in vettori con lo stesso motore Rust che fa girare i modelli
della chat, nello stesso processo — nessun secondo server, niente Python. Legge le famiglie di
encoder che la libreria mlx-embeddings copre per BERT e XLM-RoBERTa, tradotte e verificate
contro di lei nello stesso modo in cui le famiglie della chat si verificano contro mlx-lm.
Il modello che usa è quello che scegli nelle Impostazioni, o il primo modello di embedding che hai scaricato. Se non ne hai nessuno risponde 503, «nessun modello di embedding caricato» — che vuol dire scaricane uno, non che l'endpoint manchi. La forma della richiesta è quella di OpenAI: una stringa o una lista di stringhe in ingresso, un vettore per ciascuna in uscita. Troppi testi in una sola richiesta sono un 413 che dice il limite, non un'attesa che scade.
Cosa non fa
Gli strumenti li restituisce, non li esegue. Manda tools con la richiesta e le chiamate del
modello ti tornano nella forma giusta per il tuo protocollo; eseguirle è compito del tuo client.
La chat di Runlix è l'unico posto in cui le esegue Runlix.
Se il chat_template di un modello non sa cosa siano gli strumenti, la richiesta riesce lo stesso
e un avviso va nei log — il protocollo OpenAI non ha un campo per dire «ho passato questa roba e
non l'ha capita nessuno».
Il parametro stop viene accettato e ignorato: il motore implementa le sequenze di arresto, e
l'API oggi non gliele passa. L'endpoint degli embedding di Ollama non c'è: gli embedding stanno sui
percorsi di OpenAI.
Una generazione per volta; una seconda richiesta in contemporanea viene rifiutata invece di restare in coda dietro a un'attesa che nessuno sa quanto dura.
Metterci davanti qualcosa
Se vuoi davvero raggiungerla da un'altra macchina, la forma che funziona è un proxy inverso sullo
stesso Mac, in ascolto dove vuoi tu e che inoltra a 127.0.0.1:11435. È il proxy il posto
dell'autenticazione — un gettone, TLS mutuo, un fornitore di identità, quello che il tuo caso
richiede — perché è un pezzo che ha un manutentore e un modello di minaccia, e una casella in un
pannello di impostazioni non è né l'uno né l'altro.
Due cose da tenere a mente se lo fai. La generazione è una per volta, quindi un endpoint condiviso rifiuterà le richieste che arrivano durante un'altra; se devono usarlo in più persone, il proxy ha bisogno di una coda e di una decisione su quanto un chiamante aspetta. E non c'è nessuna contabilità per chiamante: i numeri d'uso in ogni risposta sono veri per quella risposta e non vengono sommati da nessuna parte.
I messaggi non si appiattiscono mai
Vale la pena dirlo perché è il modo più comune in cui un'API locale produce risposte peggiori di
quanto il modello sappia fare. I messaggi si passano come array strutturato e il chat_template
lo applica il motore, perché il motore è il pezzo che ha in mano il tokenizer.
Misurato su uno stesso modello, stesso prompt: col template la risposta è "Paris.". Appiattita
in righe ruolo: contenuto diventa "Paris\nassistant: …\nuser: What" — il modello continua a
inventarsi turni. Non sembra un difetto. Sembra un modello peggiore.